Ваш AI‑стартап похож на все остальные
«Ревью с полным контекстом кодовой базы». «Меньше шума». «Находите ошибки до выпуска». После нескольких страниц AI-инструментов для code review эти обещания начинают сливаться. Я разобрала лендинги CodeRabbit, Qodo, Greptile и cubic, чтобы проверить, можно ли по публичной странице понять, чем продукты отличаются и в какой ситуации о них стоит вспомнить.
Это разбор текстов публичных страниц, доступных на момент подготовки статьи в октябре 2026 года. Я смотрела, какую проблему описывает компания, как объясняет механизм работы, чем подкрепляет обещания и помогает ли понять условия применения. Я не запускала инструменты на одинаковом наборе изменений. Поэтому здесь нет рейтинга точности, скорости или качества поиска ошибок. Если ниже написано, что продукт находит баги, это означает, что такую возможность заявляет поставщик. Я не измеряла узнаваемость брендов и не проводила визуальный тест без логотипов. По пяти страницам нельзя доказать, что «все AI-стартапы одинаковые». Зато можно увидеть, где язык категории помогает разобраться, а где перестает давать полезную информацию.
Посетитель страницы может ничего не покупать
Мы часто обсуждаем лендинг так, будто человек уже выбирает инструмент. Он сравнивает тарифы, проверяет интеграции и решает, к какому репозиторию подключить пробную версию. Но возможен другой сценарий. Разработчик увидел ссылку в обсуждении. Тимлид прочитал статью о ревью. CTO попросили посмотреть новый сервис. Задачи купить инструмент у них пока нет.
Здесь полезна логика правила 95 к 5, которое касается категорий с длинным циклом покупки: если компания меняет основной банк или юридического консультанта примерно раз в пять лет, в течение квартала на рынке оказывается лишь небольшая часть потенциальных покупателей. Остальные могут встретить рекламу, но покупка произойдет позже. 95% тут служат ориентиром, не универсальной константой. Поэтому переносить соотношение 95 к 5 на AI code review нельзя. Но сам вопрос полезен: что получит человек от страницы, если сегодня он не собирается подключать продукт?
Возможно, он запомнит название. Возможно, только фразу «еще один AI-ревьюер». А возможно, свяжет продукт с конкретной задачей: «когда изменения общей библиотеки начнут ломать соседние сервисы, вернусь к этому инструменту».
Сходство начинается с объяснения проблемы
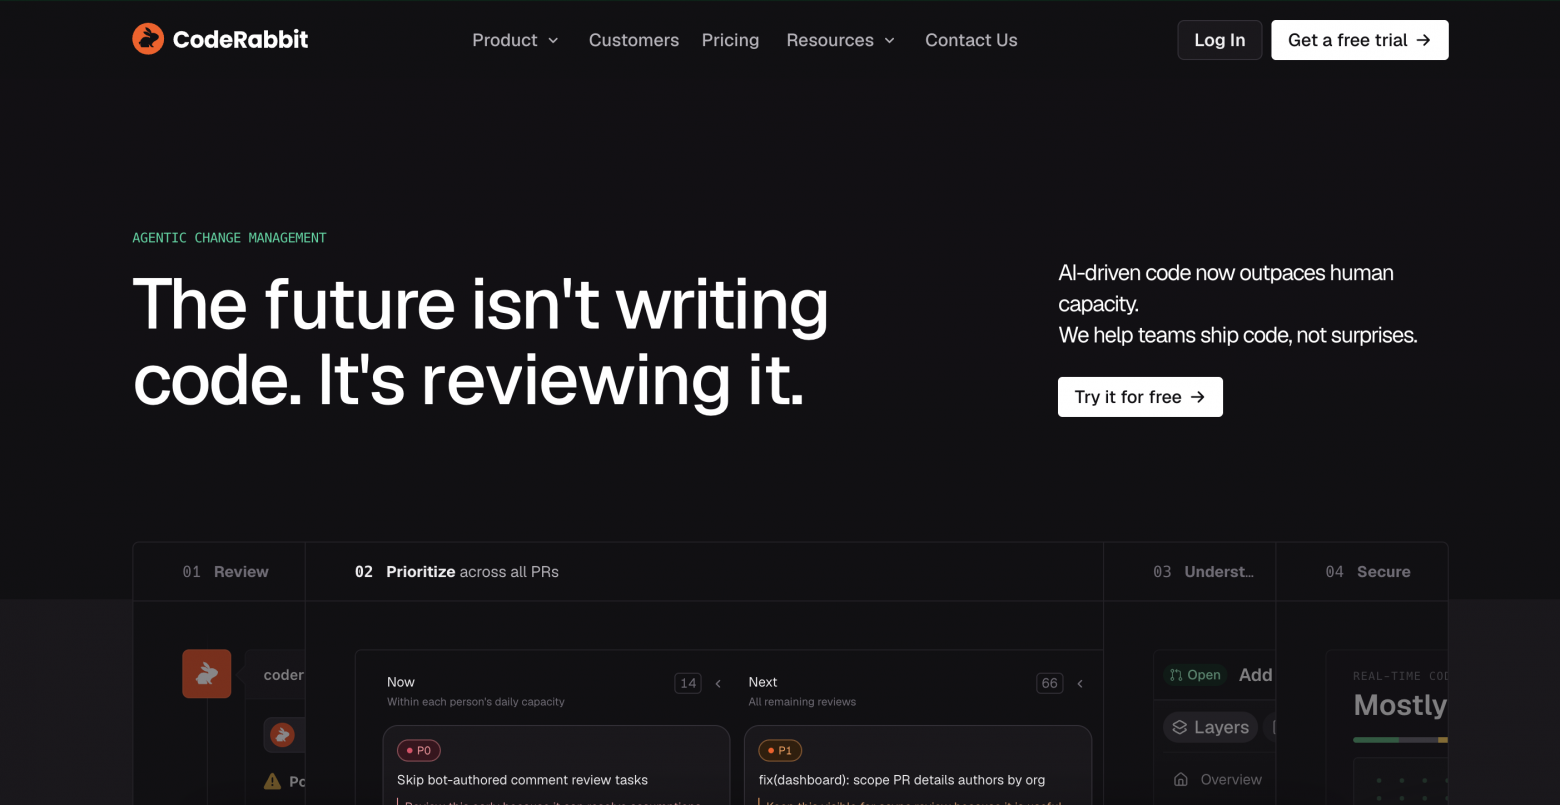
У CodeRabbit проблема сформулирована прямо: AI-код появляется быстрее, чем люди успевают его проверять. Дальше компания раскладывает работу на проверку, приоритизацию, понимание изменений и безопасность.
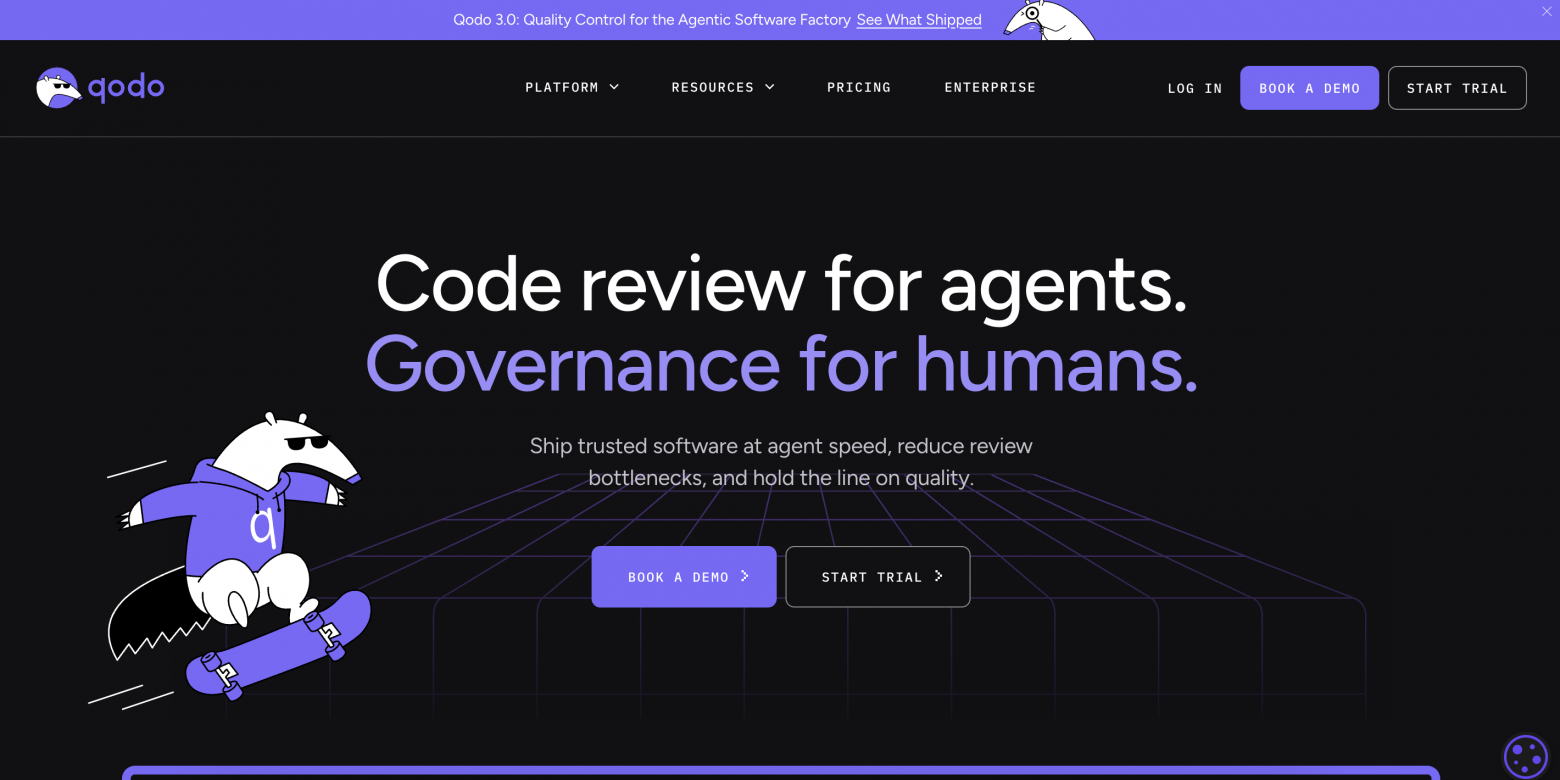
Qodo строит похожую историю. Прежняя модель ревью опиралась на разработчика, запрос на изменения и опытного коллегу, который держит устройство системы в голове. Компания утверждает, что объем агентной разработки требует другого подхода: правил, автоматической проверки и контроля качества между командами.
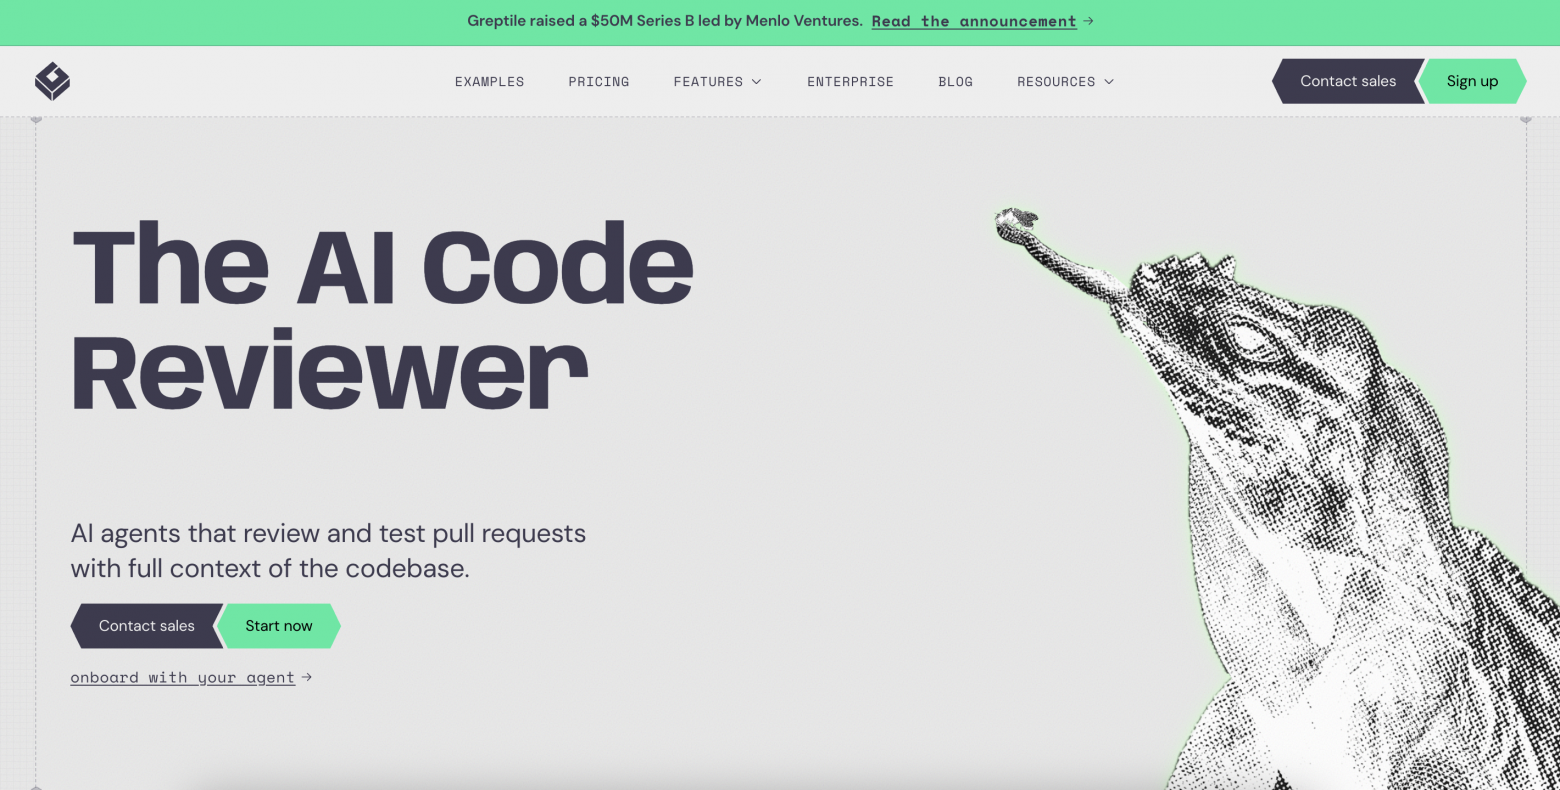
У Greptile и cubic вход короче. Greptile предлагает агентов, которые проверяют и тестируют pull request с контекстом кодовой базы. Cubic обещает находить сложные ошибки в запросах на изменения и во всем репозитории.
Эти формулировки обозначают понятную категорию. Читатель узнает задачу: кода много, проверка занимает время, часть ошибок зависит от того, что происходит за пределами измененных строк. Но общее описание проблемы еще не объясняет выбор поставщика. Если заменить название одного сервиса другим, фраза «AI-ревью с контекстом кодовой базы» во многих случаях останется правдоподобной. Это полезный редакторский тест.
Если предложение подходит нескольким конкурентам, стоит дополнить его сценарием, механизмом или условием применения. При этом взаимозаменяемая фраза еще не доказывает, что бренд плохо запоминается.
В какой момент о продукте должны вспомнить
Покупатель вспоминает о продукте, когда возникает конкретная задача: очередь ревью растет, изменения ломают соседние сервисы или требования безопасности мешают подключить внешний инструмент. Такие ситуации называют точками входа в категорию. Они помогают понять, в какой момент и по какой причине человек начинает искать решение.
Для инструмента проверки кода возможные ситуации звучат так: «после внедрения coding-агентов выросла очередь изменений», «изменения в общей библиотеке ломают зависимые сервисы», «правила команды существуют в комментариях старших разработчиков, но новые сотрудники их не знают», «мы готовы попробовать AI-ревью, но код нельзя отправлять во внешний SaaS».
Разница с перечнем функций заметна сразу. «Поддерживаем несколько репозиториев» описывает возможность. «После изменения общего API нужно проверить зависимые сервисы» описывает обстоятельство, в котором эта возможность нужна.
Так коммуникация связывает бренд с релевантными ситуациями покупки. Список функций может помогать этому, если читатель узнает в нем свою задачу. Повторение слова AI такой связи само по себе не объясняет.
За общими словами обнаружились разные продукты
Если читать страницу дальше, сходство уменьшается. Компании предлагают разные способы встроиться в работу команды.
CodeRabbit описывает продукт через agentic change management. На странице рядом с ревью находятся приоритизация очереди, назначение проверяющих, работа с крупными изменениями и безопасность. Я читаю это предложение так: когда изменений становится слишком много, команде нужно определить, что проверить первым, кому это поручить и как разобраться в большом объеме кода. Здесь возможная точка входа связана с потоком работы. Посетитель мог прийти за ревьюером, а обнаружить предложение для нескольких этапов обработки изменений. Коммуникационная задача компании: объяснить, при каких условиях эти дополнительные возможности ему понадобятся.
Qodo использует рамку quality control и governance. Компания описывает систему правил, историю решений, риск-аналитику и связи между репозиториями. Ее предложение я бы связывала с другой ситуацией: в организации много команд, а инженерные требования применяются по-разному. Часть правил записана в документации, часть осталась в обсуждениях, часть существует в голове опытных разработчиков. Покупатель в этой ситуации ищет способ сделать проверку более последовательной. Ему важно понимать, какие правила действуют, где они нарушаются и почему решение было принято именно так.
Greptile строит объяснение вокруг понимания кодовой базы. Компания описывает граф файлов, функций и зависимостей, параллельных агентов и обучение на комментариях инженеров. Это позволяет сформулировать конкретную задачу: изменение выглядит корректным в пределах одного файла, но затрагивает другой участок системы. Технический механизм помогает разобраться в обещании. Читатель может спросить, какие зависимости попадают в граф, как он обновляется и что инструмент способен проверить за пределами измененных строк.
Cubic делает акцент на поиске сложных ошибок и движении pull request к слиянию. На странице описаны автоматическое одобрение изменений с низким риском, оценка уверенности в слиянии и передача замечаний coding-агентам. Я бы связала это предложение с ситуацией, когда команда уделяет одинаковое внимание изменениям с разным уровнем риска. Простые правки стоят в очереди рядом со сложными. Вопрос покупателя вполне прикладной: какие изменения можно пропускать автоматически, а какие требуют проверки человеком?
Ellipsis выходит за границу этой группы. Пользователь задает агента и окружение, а платформа предлагает вычисления, управление правами, бюджеты и записи сессий. Code review выступает одним из сценариев. Возможный покупатель Ellipsis уже решил, какого агента хочет запускать, или собирается создать своего. Теперь ему нужна инфраструктура. Поэтому отличие Ellipsis от остальных страниц отчасти объясняется другой задачей продукта. Считать это победой в позиционировании было бы поспешно.
Что скрывается за словом context
Самое показательное слово в этой выборке: контекст. Оно может означать соседние строки, весь репозиторий, зависимости между сервисами, историю обсуждений или требования из задачи. Для выбора инструмента это разные вещи.
Greptile описывает последовательность: построить граф репозитория, проверить изменение параллельными агентами, учитывать комментарии инженеров для понимания стандартов команды. Компания отдельно говорит об оценке последствий за пределами diff, то есть набора измененных строк.
Qodo перечисляет источники: кодовая база, история pull request, правила и бизнес-требования из задач и спецификаций. Для проверки между репозиториями приводит сценарий: изменение сигнатуры функции в общей библиотеке может сломать зависимый код.
У CodeRabbit перечислены граф кода, история, документация, требования к продукту и задачи. Страница показывает, как замечание связывается с последующим исправлением и повторной проверкой. Это демонстрация предполагаемого процесса, а не независимый тест его качества.
Cubic связывает контекст с проверкой всей кодовой базы, зависимостями между репозиториями и правилами, извлеченными из прежних комментариев инженеров.
После такой расшифровки можно задавать предметные вопросы. Какие зависимости инструмент действительно видит? Как обновляется индекс? Может ли он прочитать закрытый соседний репозиторий? Как поступает, если требования в задаче расходятся с кодом? Какие источники доступны в выбранном тарифе? На лендинге не обязательно отвечать на все. Достаточно показать механизм и дать путь к подробностям. Тогда покупатель понимает, что именно проверять на пилоте.
Может быть, нас не отвергают. О нас просто не знают
Есть еще одна причина не сводить страницу к бесконечной обработке возражений. Недостаток знаний о бренде может стать более масштабной проблемой, чем отрицательное отношение к нему. И это дает полезную альтернативу привычному объяснению: «нас не выбирают, потому что мы недостаточно убедили». Возможно, покупатель еще не дошел до оценки аргументов. Он не вспомнил продукт, не понял его назначения или не связал с возникшей задачей.
Однако я не стала бы делать вывод, что запоминающийся лендинг важнее страницы, которая снимает возражения. Задачи разные. На первом знакомстве человеку нужно понять, что это за продукт и когда к нему вернуться. Перед подключением корпоративного репозитория ему понадобятся ответы о данных, доступе и договорных условиях. Один и тот же посетитель может пройти оба этапа с разницей в несколько месяцев. Страница должна позволять читать ее с разной глубиной.
Сильная цифра еще не отвечает на вопрос «сработает ли у нас»
CodeRabbit публикует показатели масштаба: 17 тысяч клиентов и 6 миллионов репозиториев. Рядом есть заявленные результаты отдельных кейсов. Например, 30% экономии времени у Writer при 50 pull request в день и более 100 часов работы ревьюеров, сэкономленных за 30 дней у Abnormal. Это данные поставщика, опубликованные на его странице. Они отвечают на разные вопросы.
Число подключенных репозиториев показывает заявленный масштаб внедрения. Оно не позволяет определить, сколько из них активно, как часто там запускается ревью и какую пользу получает команда.
Результат клиента ближе к задаче покупателя, но требует контекста. Что именно считали временем ревью: активное чтение кода или весь период до слияния? Как выбирали изменения? Менялись ли размер команды и сложность задач?
Qodo заявляет на странице самый высокий F1-score на бенчмарке AI code review. Cubic выносит утверждение о первом месте на независимых бенчмарках и ссылку на отчет.
Я бы разделяла такие данные на три уровня.
Первый: объем использования. Сколько pull request обработано, сколько репозиториев подключено, сколько комментариев создано. Здесь нужны период, определение активности и правила подсчета.
Второй: результат клиента. Например, сколько времени команда сэкономила на ревью. Здесь нужно знать исходный процесс, состав выборки и способ измерения.
Третий: качество обнаружения проблем. Здесь нужны разметка тестового набора, языки, типы ошибок, настройки и версии инструментов.
Фраза «мы создали миллион комментариев» допускает противоположные интерпретации. Возможно, инструмент нашел много полезного. Возможно, командам пришлось прочитать миллион лишних сообщений. Без оценки полезности объем комментариев не позволяет выбрать между этими объяснениями. Отсутствие полной методики в заголовке не делает цифру недостоверной. Важнее, может ли читатель перейти от короткого заявления к условиям измерения.
Требования безопасности могут стать причиной поиска продукта
Я бы не писала, что безопасность «больше не отличает продукты». Условия развертывания и обработки данных могут определять, попадет ли сервис в список кандидатов.
Greptile заявляет self-hosted-развертывание, включая изолированную среду, а также SSO и журналы аудита. Qodo описывает отсутствие хранения кода, on-premises и выделенное развертывание. Cubic сообщает, что не хранит код и не обучает на нем модели.
Это заявления поставщиков. Они требуют проверки по документации, договору и конкретной конфигурации. Но уже на уровне страницы покупатель видит вопросы, которые стоит вынести на техническое согласование.
У Ellipsis есть показательная деталь: исходный код удаляется вместе с окружением сессии, при этом записи команд и действий сохраняются для аудита. Эти два утверждения могут сосуществовать, потому что речь о разных типах данных. Их стоит читать отдельно.
С точки зрения точек входа в категорию здесь возможна отдельная ситуация: «нам разрешили пилот AI-инструмента, если код останется внутри нашей инфраструктуры». В таком случае информация о развертывании может стать причиной запомнить продукт. Но сначала нужно проверить, действительно ли покупатели приходят с таким требованием и позволяет ли продукт его соблюсти.
Как собрать точки входа для своего IT-продукта
Стоит поговорить с покупателями. Что происходило до того, как они начали искать решение? Почему вопрос возник в тот момент? Как обходились раньше? Кто первым заметил проблему? Какое ограничение могло остановить покупку?
Поэтому в коммуникационном агентстве «ЛАМПА» мы начинаем работу над сообщениями IT-продукта с вопроса: в какой ситуации он должен понадобиться покупателю? Ответ помогает выбрать, что объяснять на лендинге, какой кейс разбирать в статье и чем подкреплять обещания.
Вопрос «какие функции вам нужны» я бы оставила на потом. На него легко получить список возможностей. Нам нужна последовательность событий, после которой человек решил что-то менять.
Дальше можно записать гипотезы в короткой форме: когда происходит X, нам нужно сделать Y, при условии Z.
Например: «Когда изменение общей библиотеки затрагивает несколько сервисов, нам нужно проверить, не сломает ли оно использующие её сервисы. Сделать это нужно до слияния, хотя код хранится в разных репозиториях».
В этой фразе уже можно проверить связь с продуктом. Есть ли у него нужный доступ? Поддерживает ли он такие связи? Может ли показать пример обнаруженной проблемы? Где заканчивается его покрытие?
Для приоритизации можно учитывать распространенность ситуации, правдоподобие связи бренда с ней и конкуренцию. Но не стоит придумывать редкую проблему ради отличия. Частая задача, которую продукт убедительно решает, может быть ценнее необычного сценария.
Из подтвержденной ситуации затем получается материал для коммуникации. Кейсу можно дать исходные условия и результат. Технической статье: механизм и ограничения. Странице продукта: короткое объяснение и ссылку на доказательство. Если покупатели приходят после проблем с зависимыми сервисами, публикация о том, как инструмент анализирует межрепозиторные связи, будет связана с причиной покупки. Общая колонка «почему AI меняет разработку» такую связь еще должна создать.
При проверке результата я бы тоже разделяла вопросы. Понял ли читатель назначение продукта? Вспомнил ли бренд в конкретной ситуации? Подключил ли репозиторий? Получил ли пользу на пилоте? Это разные этапы, и одна конверсия в регистрацию не объяснит их все.
Что продуктовый PR должен оставить в памяти
У CodeRabbit, Qodo, Greptile и cubic похожий словарь, но за ним стоят разные задачи: разобрать очередь изменений, поддержать инженерные правила, проверить зависимости, сократить ручную работу. Эти различия стоит выносить в коммуникацию. По ним покупатель может понять, какой продукт рассматривать и что проверять на пилоте.
Для продуктового PR здесь есть конкретная задача: связать название компании с ситуацией, в которой её решение понадобится. Лендинг объясняет эту связь, техническая статья раскрывает механизм, кейс показывает результат в определённых условиях. Если каждый материал начинает с общих слов про AI и качество, покупателю приходится самостоятельно собирать ответ на вопрос «зачем мне это». Убедительная коммуникация сокращает этот путь. В ней есть узнаваемая задача, понятный способ её решить и доказательство, границы которого обозначены. Тогда даже у человека, который сегодня ничего не покупает, остаётся причина вернуться.
«У них тоже есть AI» оставляет продукт в общей категории. «Когда возникнет эта задача, стоит проверить их решение» даёт бренду место в будущем выборе. За эту связь и стоит бороться продуктовому PR.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.