GoogleのEmbeddingGemma 2を音声認識モデルに変換した「Embedding Gemma Transcribe」、オフライン環境のMacなら15分の音声をわずか約3秒で爆速文字起こし可能
音声をテキストに変換する文字起こしには一般的に音声認識専用のAIモデルが使われます。しかし、文章の意味を数値で表現する埋め込みモデルのEmbeddingGemma 2を利用して音声を文字起こしするという一風変わったアプローチを採用した「Embedding Gemma Transcribe」が登場しました。Embedding Gemma TranscribeはApple Silicon搭載Macで動作し、インターネット接続なしで音声を処理できるとのことなので、実際に使ってみました。
Embedding Gemma Transcribe
https://eg2.haku.sh/
EmbeddingGemma 2はテキスト、画像、音声、動画を共通の数値空間で表現する「マルチモーダル埋め込みモデル」で、音声の文字起こし用に開発されたモデルではありません。Embedding Gemma Transcribeは、EmbeddingGemma 2の音声を分析する機能をそのまま利用し、新たに学習させた小規模なAIモデルを組み合わせることで、約22万9000語の英単語の中から音声に当てはまる単語を選び出し、文字起こしを実現しています。
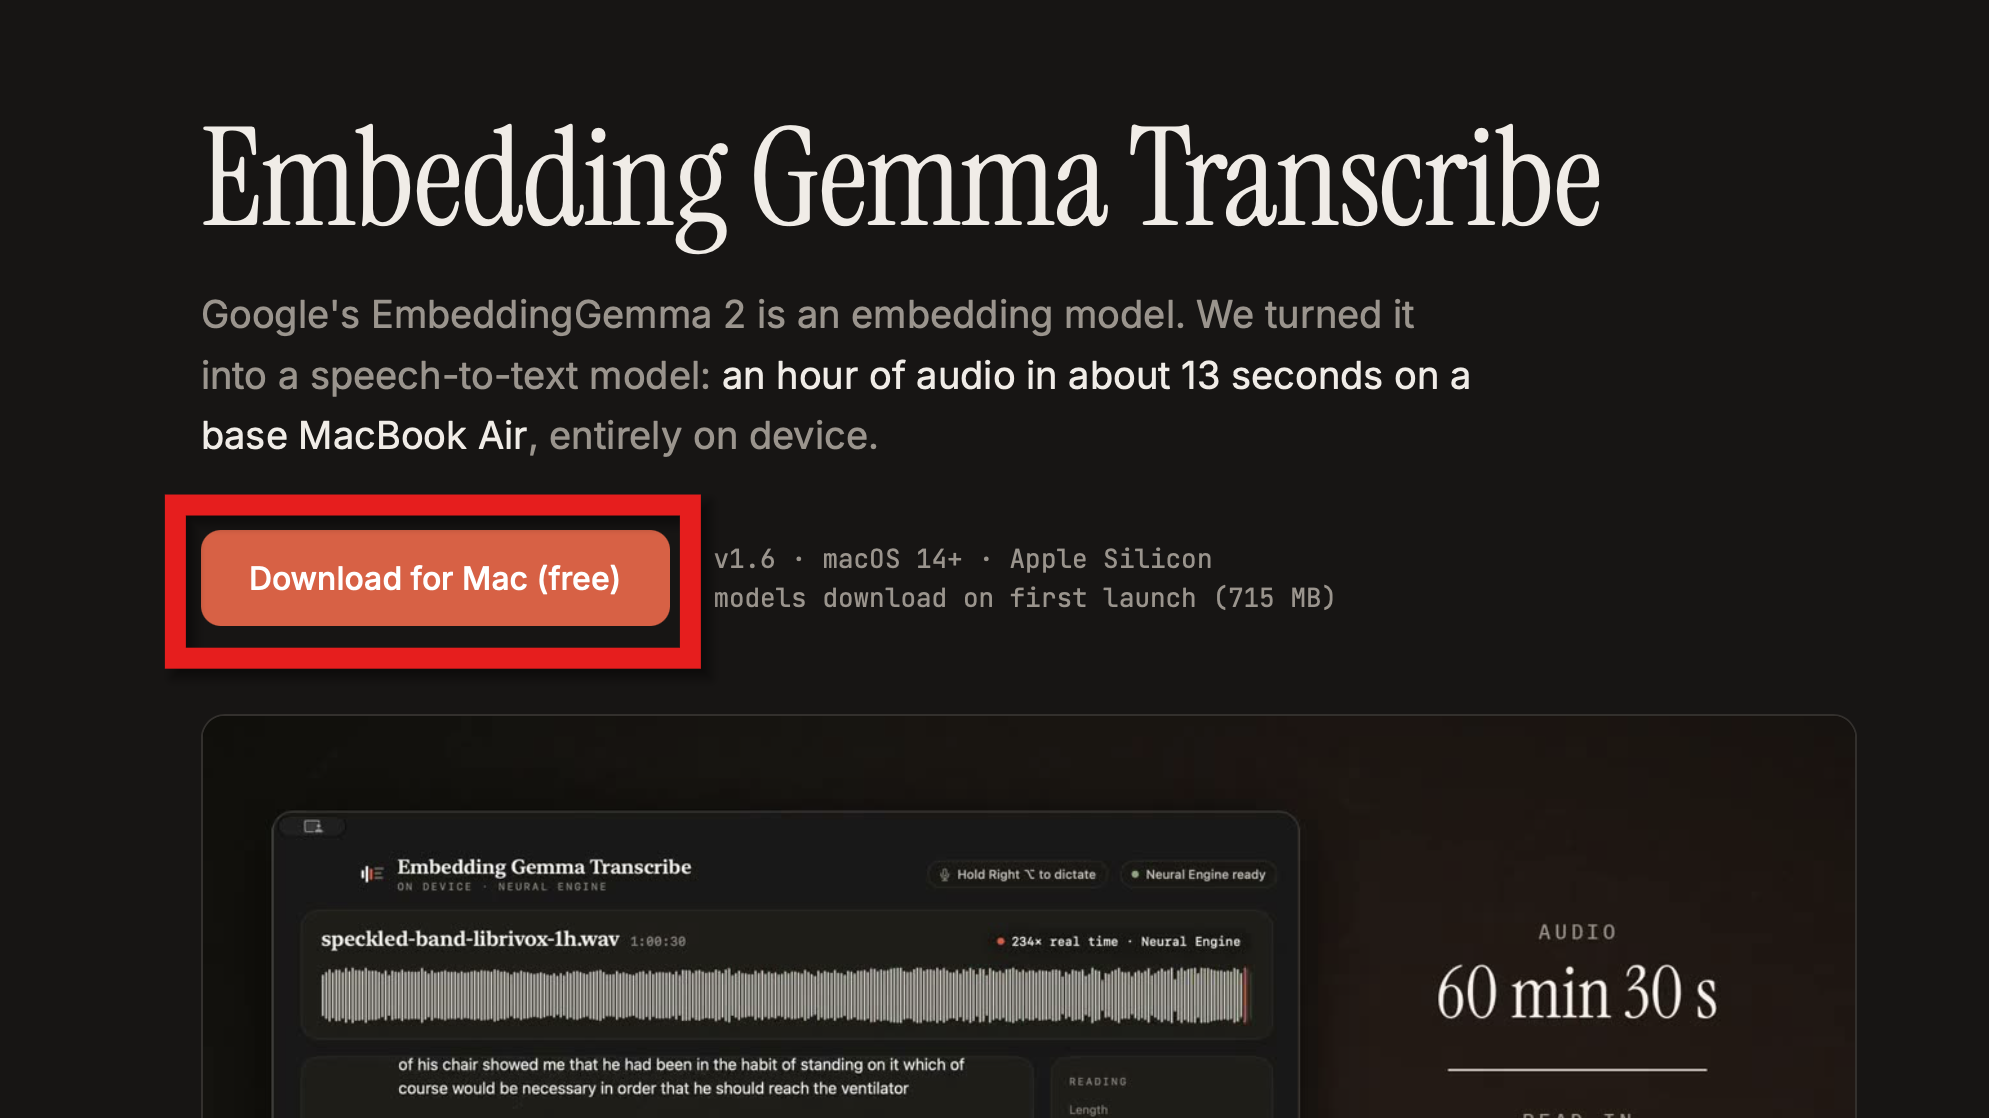
Embedding Gemma TranscribeはmacOS 14以降のApple Silicon搭載Mac向けに、記事作成時点だと無償公開されています。「Download for Mac(free)」をクリックしてディスクイメージをダウンロードし、インストールします。ファイルサイズは約2.5MBでした。
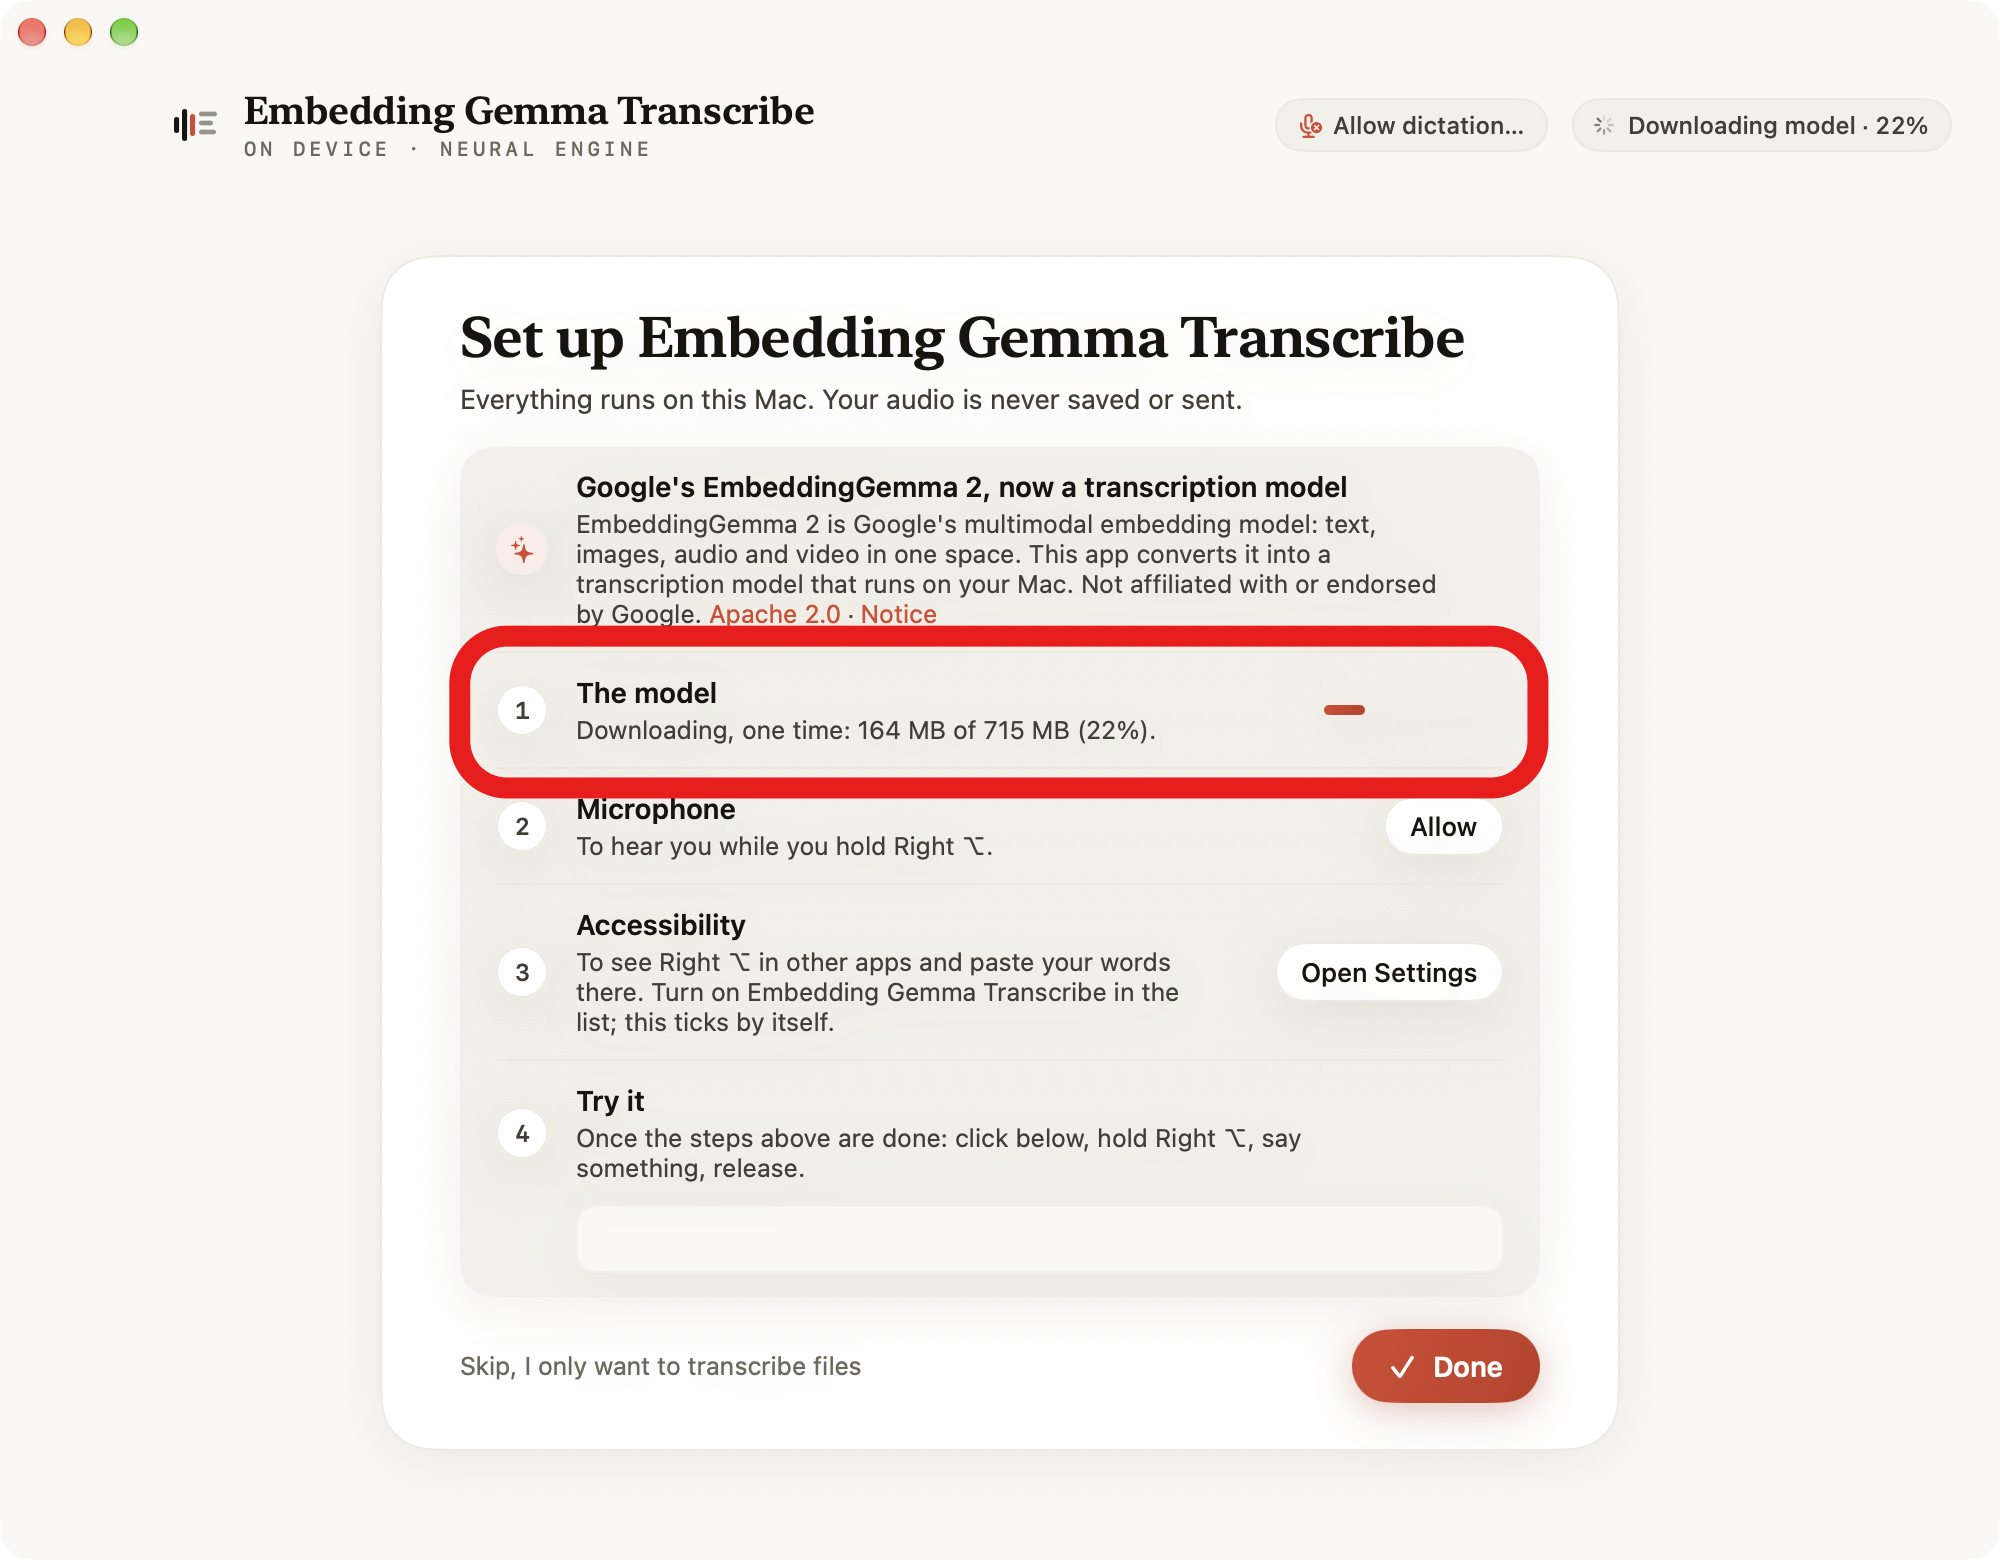
インストール後、初回起動時にモデルのダウンロードや設定を行います。モデルのファイルサイズは約715MB。
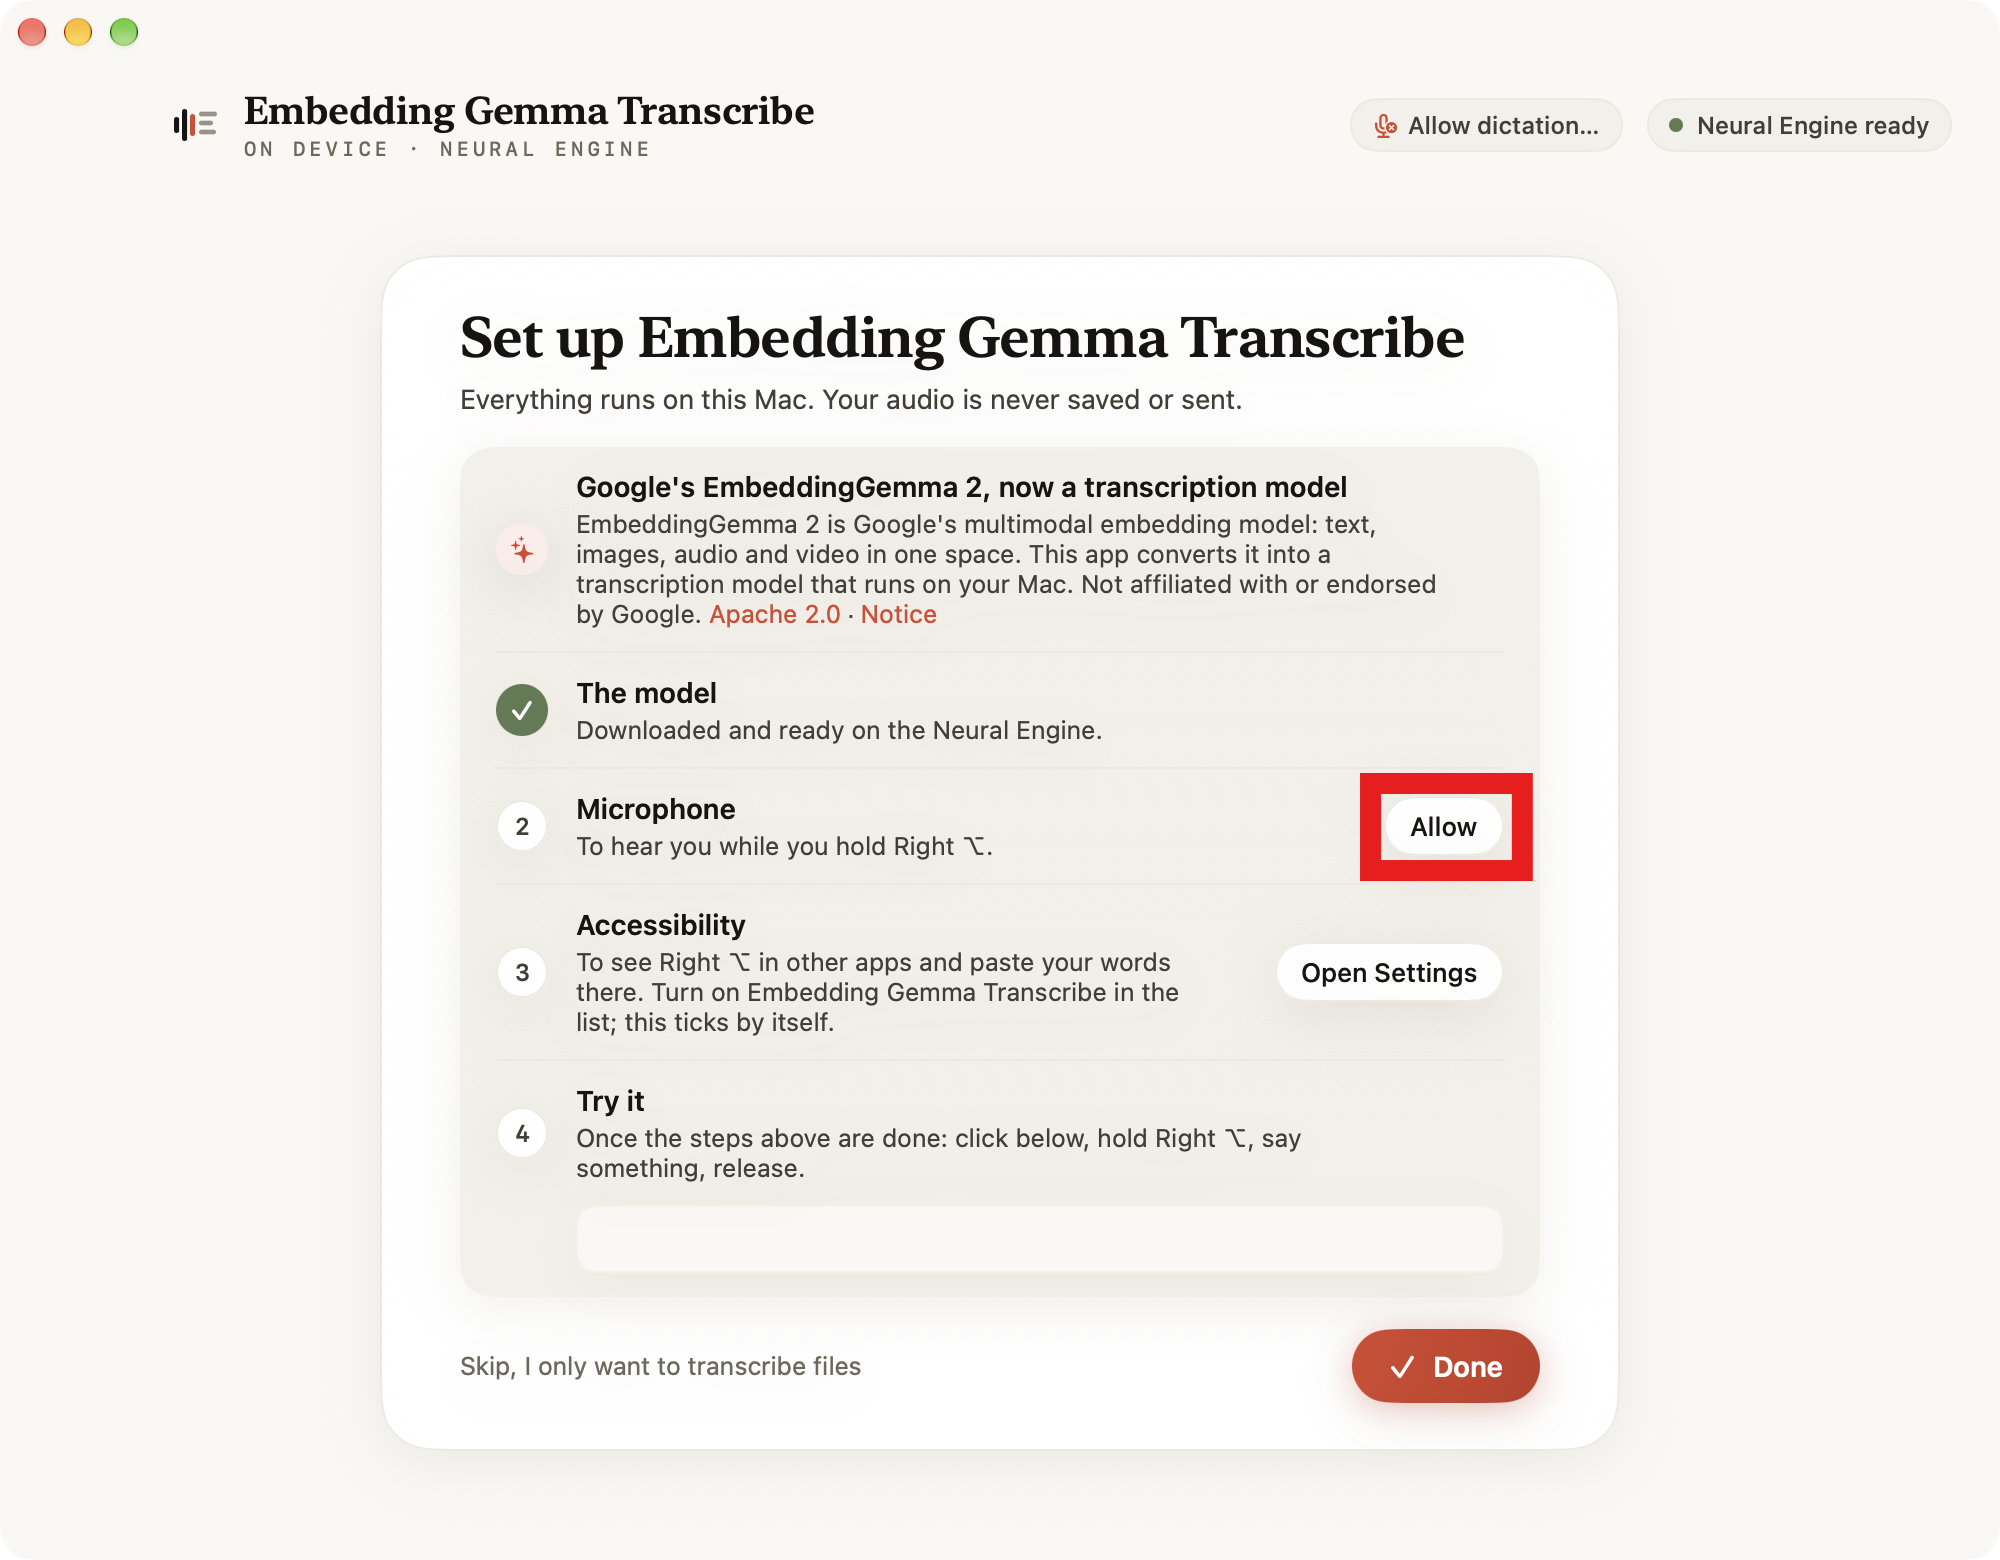
次にマイクへのアクセスを許可するため、「Allow」をクリック。
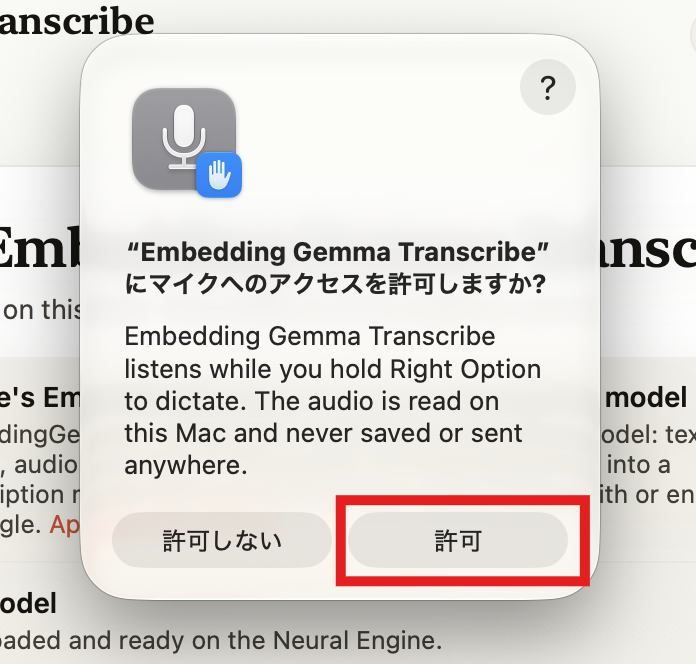
「許可」をクリック。右Optionキーを押すとマイクで収録した音声が文字起こしされます。文字起こしされる音声はMac上で処理され、別途保存されたりサーバーに送られたりすることはありません。
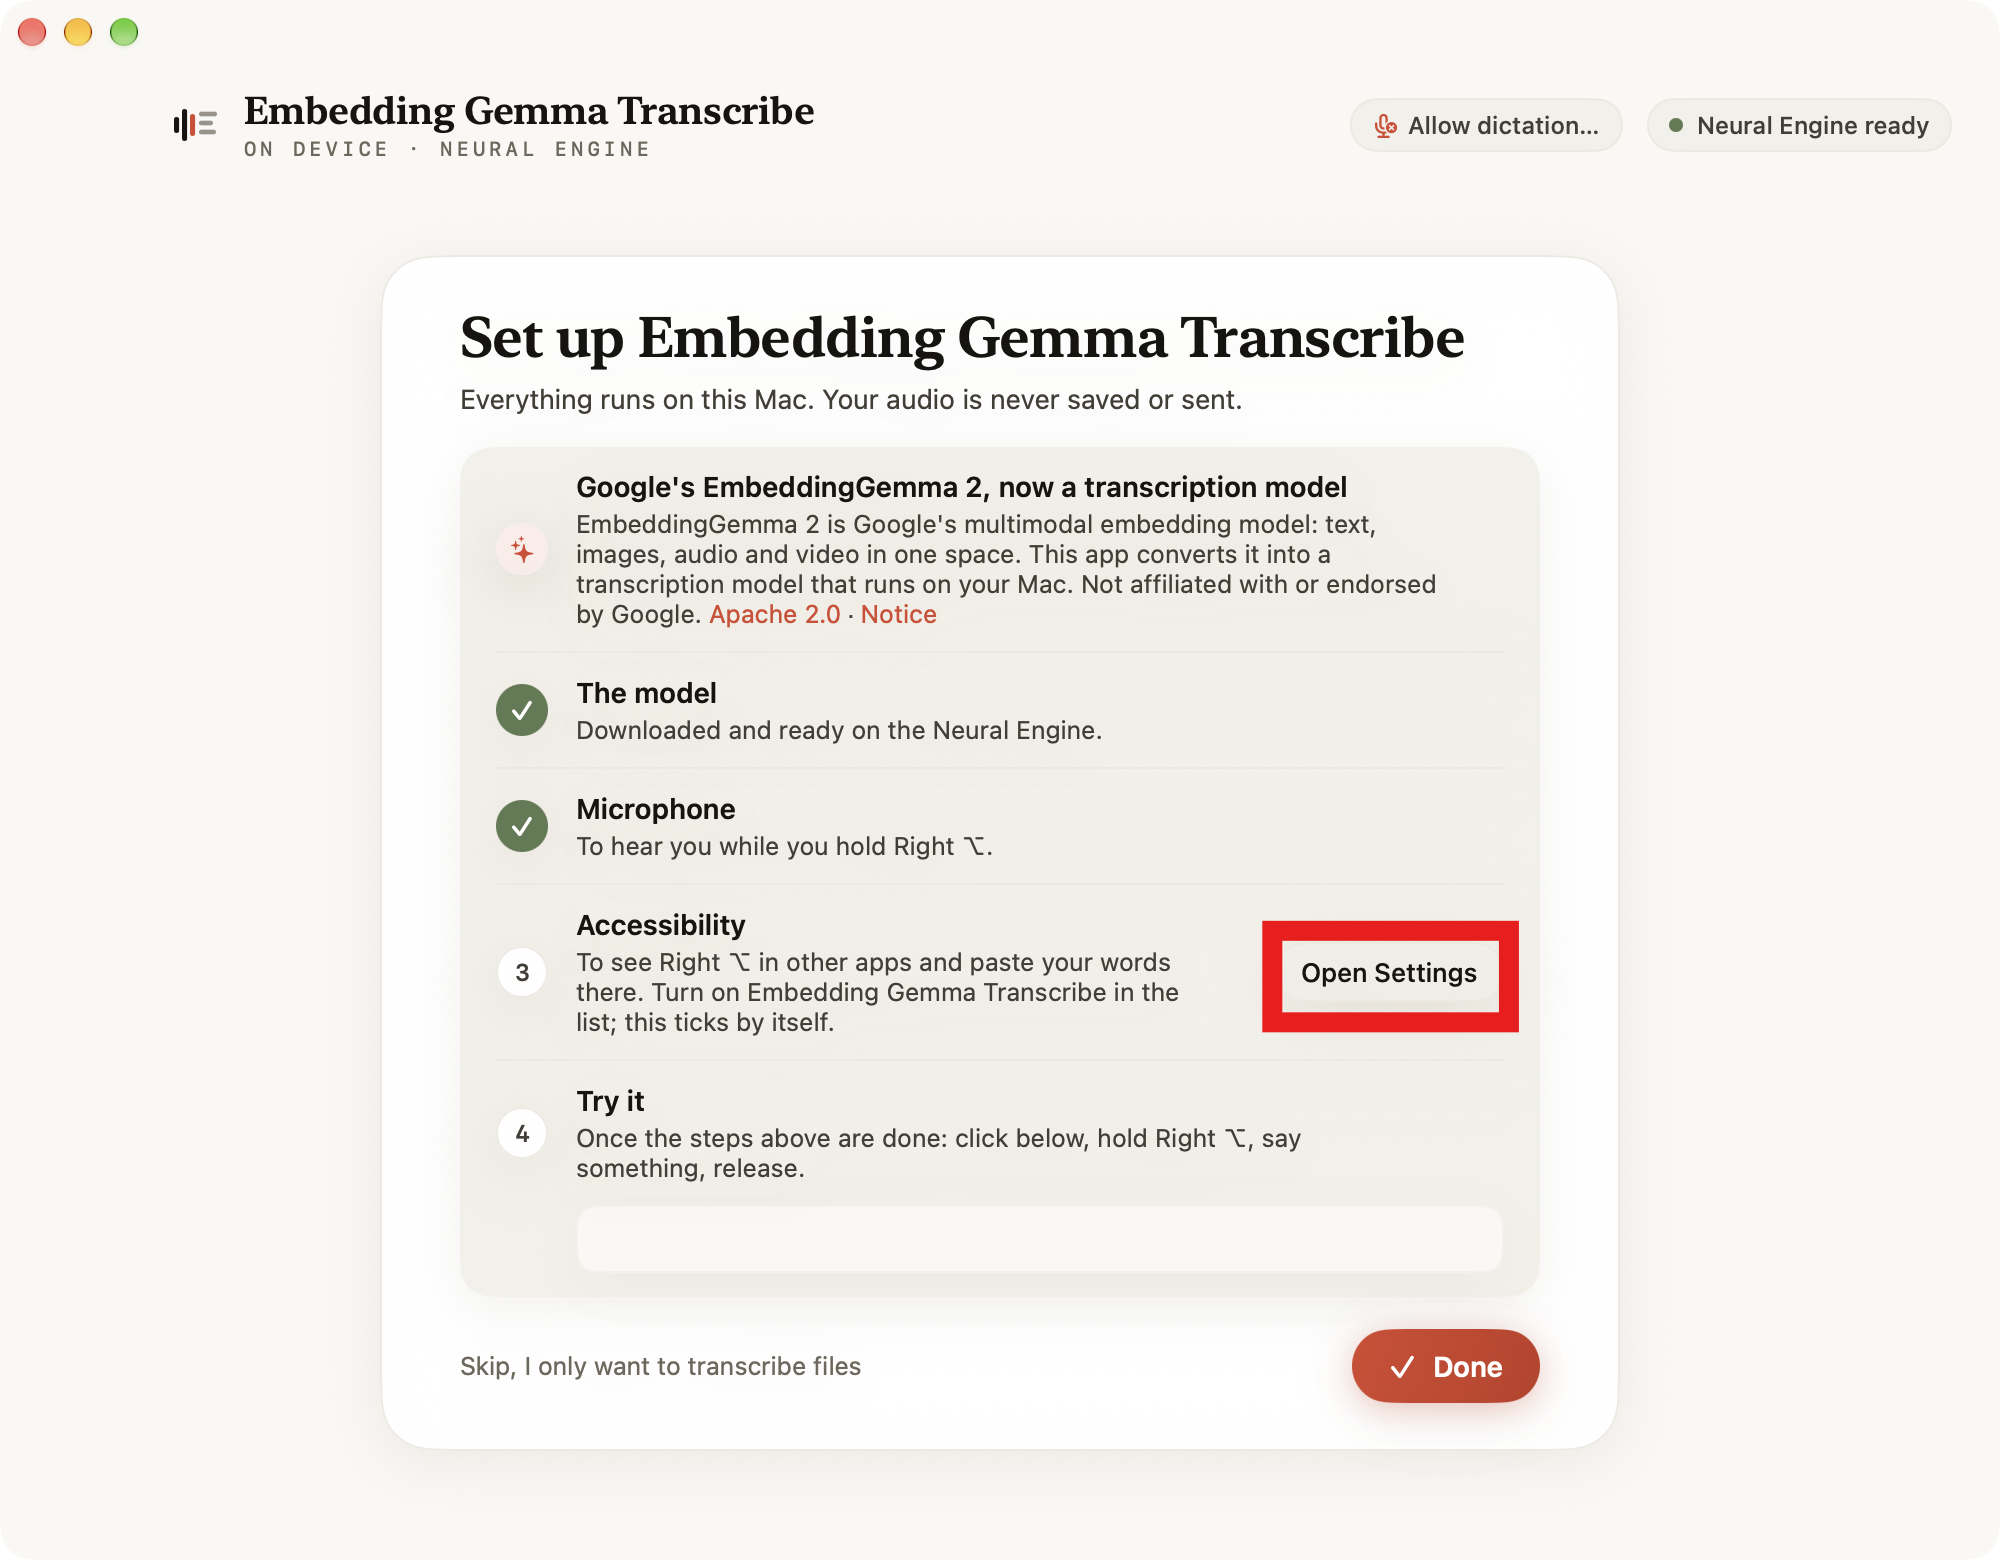
Embedding Gemma Transcribeがほかのアプリでも音声入力できるように、macOSの「アクセシビリティ」権限を許可する設定を求められます。「Open Settings」をクリック。
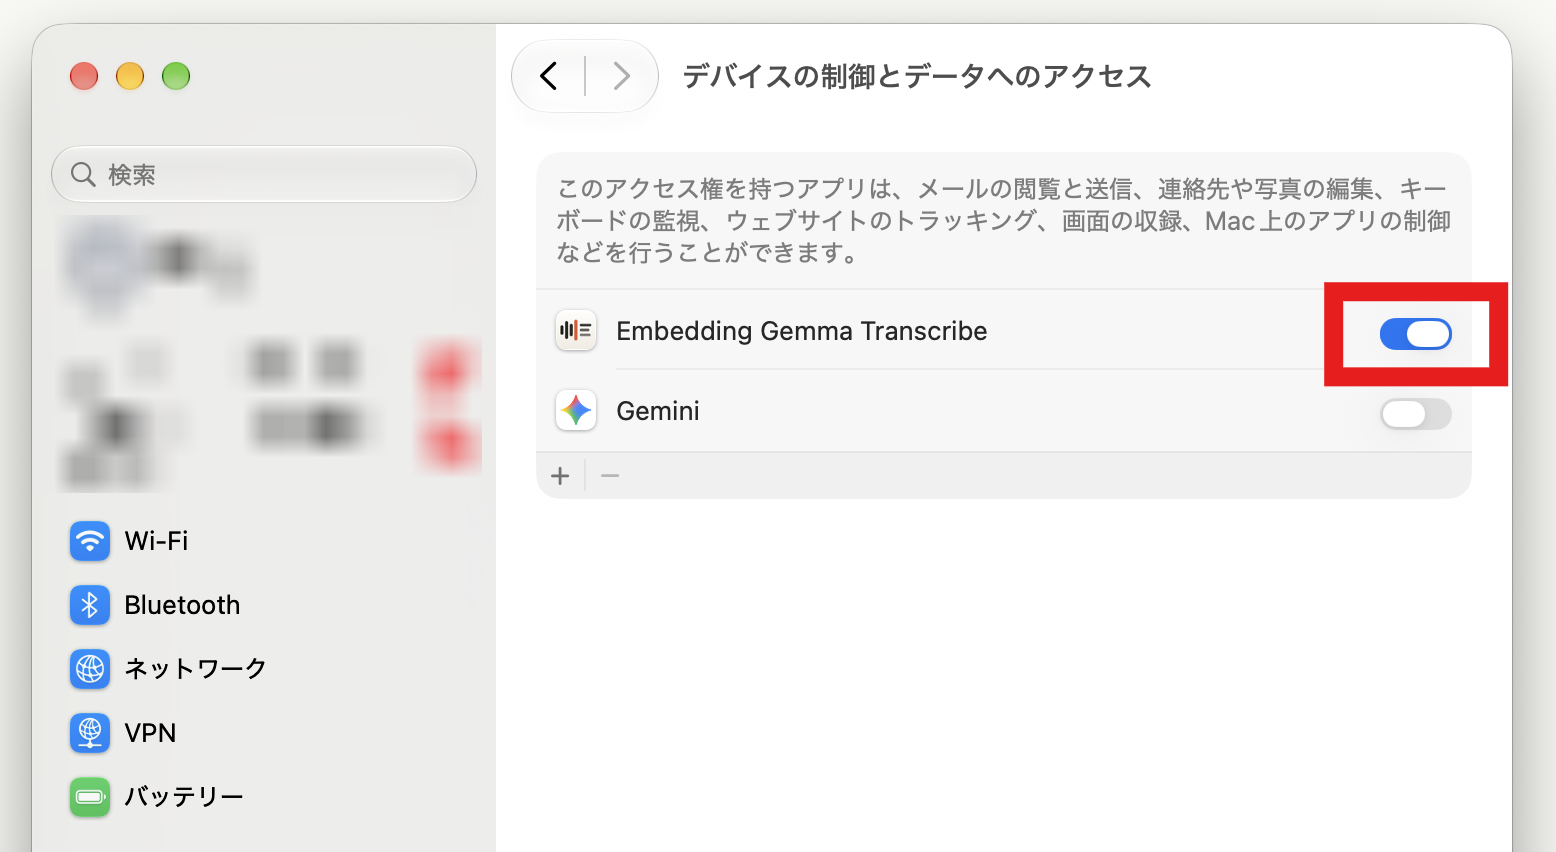
Embedding Gemma Transcribeのスイッチをオンにします。これで他のアプリで右Optionキーを押しながら話してキーを離すと、認識した英語をテキストとして入力できるようになります。
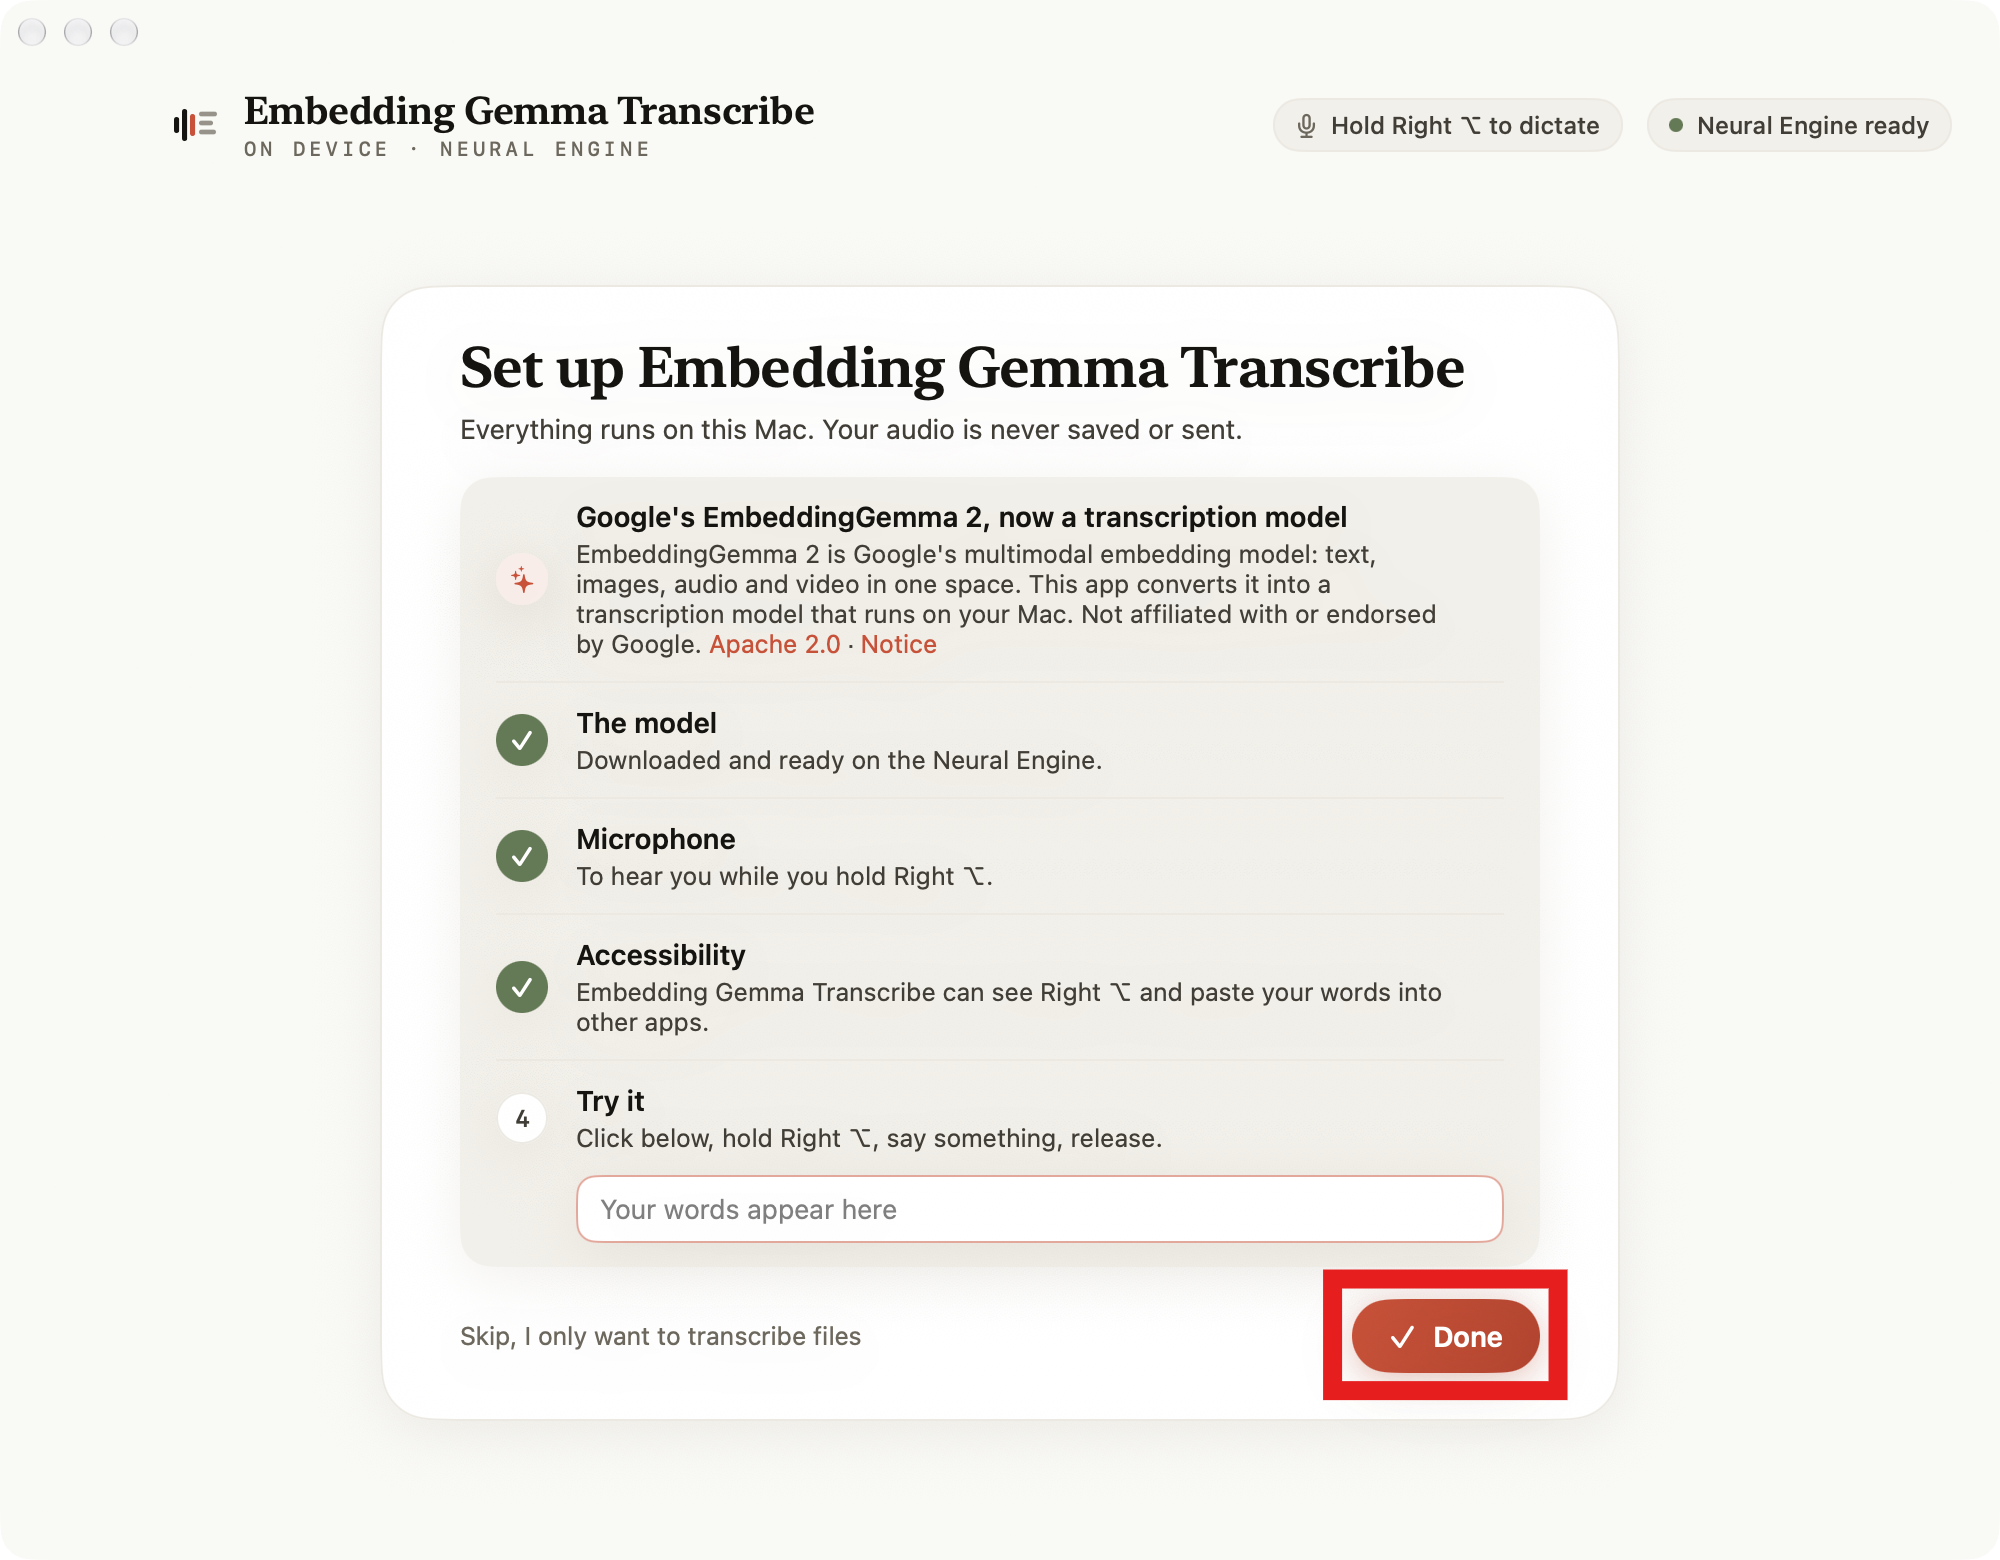
「Done」をクリック。
「Choose a file」をクリックして選択するか、文字起こししたいファイルをドラッグ&ドロップします。
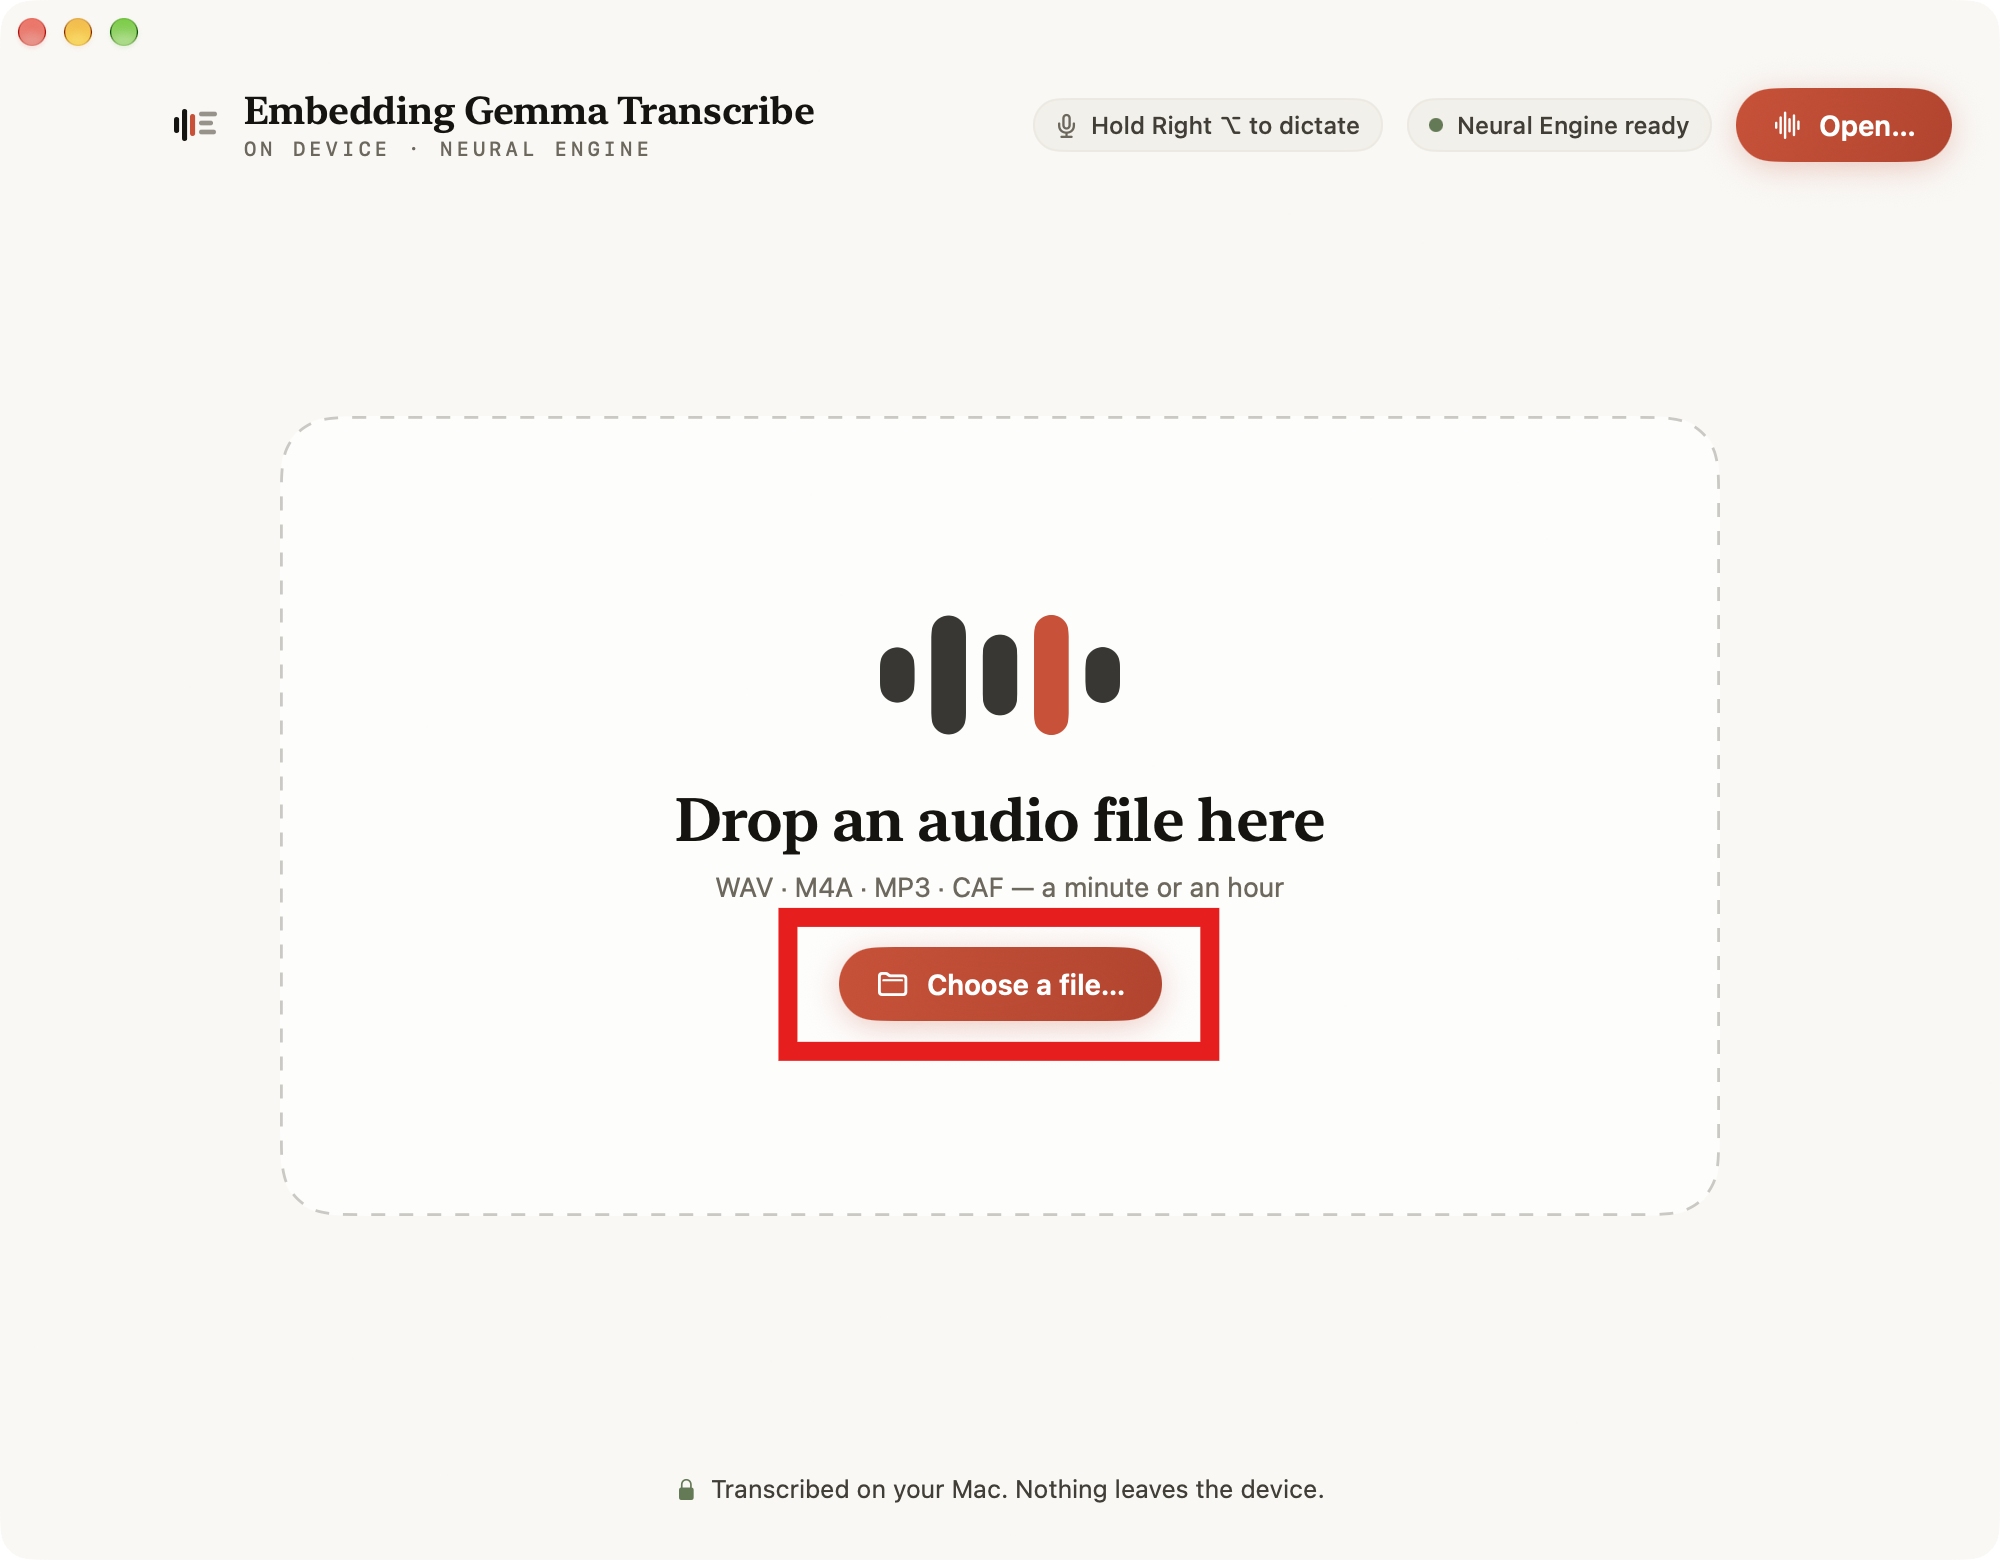
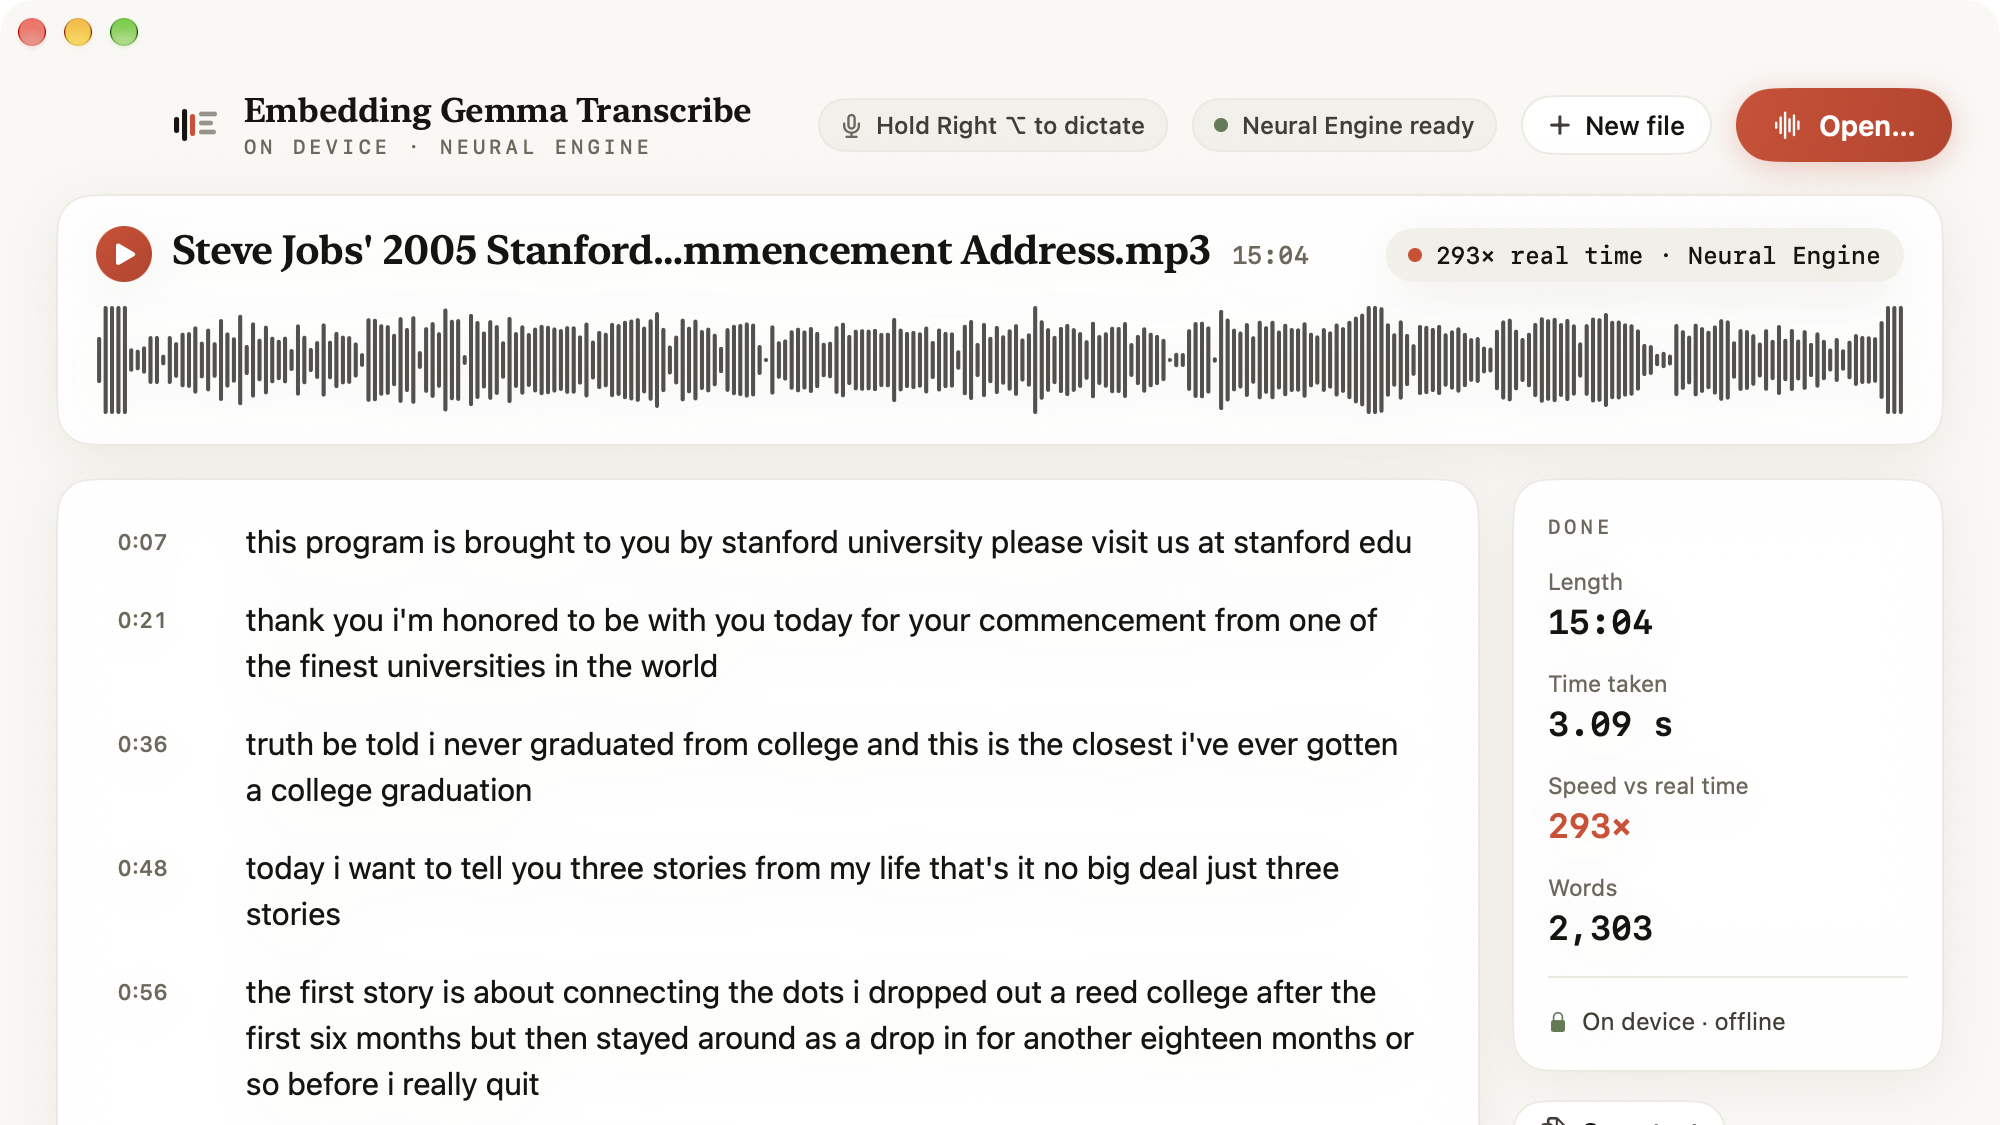
今回はスティーブ・ジョブズが2005年にスタンフォード大学学位授与式で行った演説の音声を読み込ませてみました。「Transcribe」をクリック。
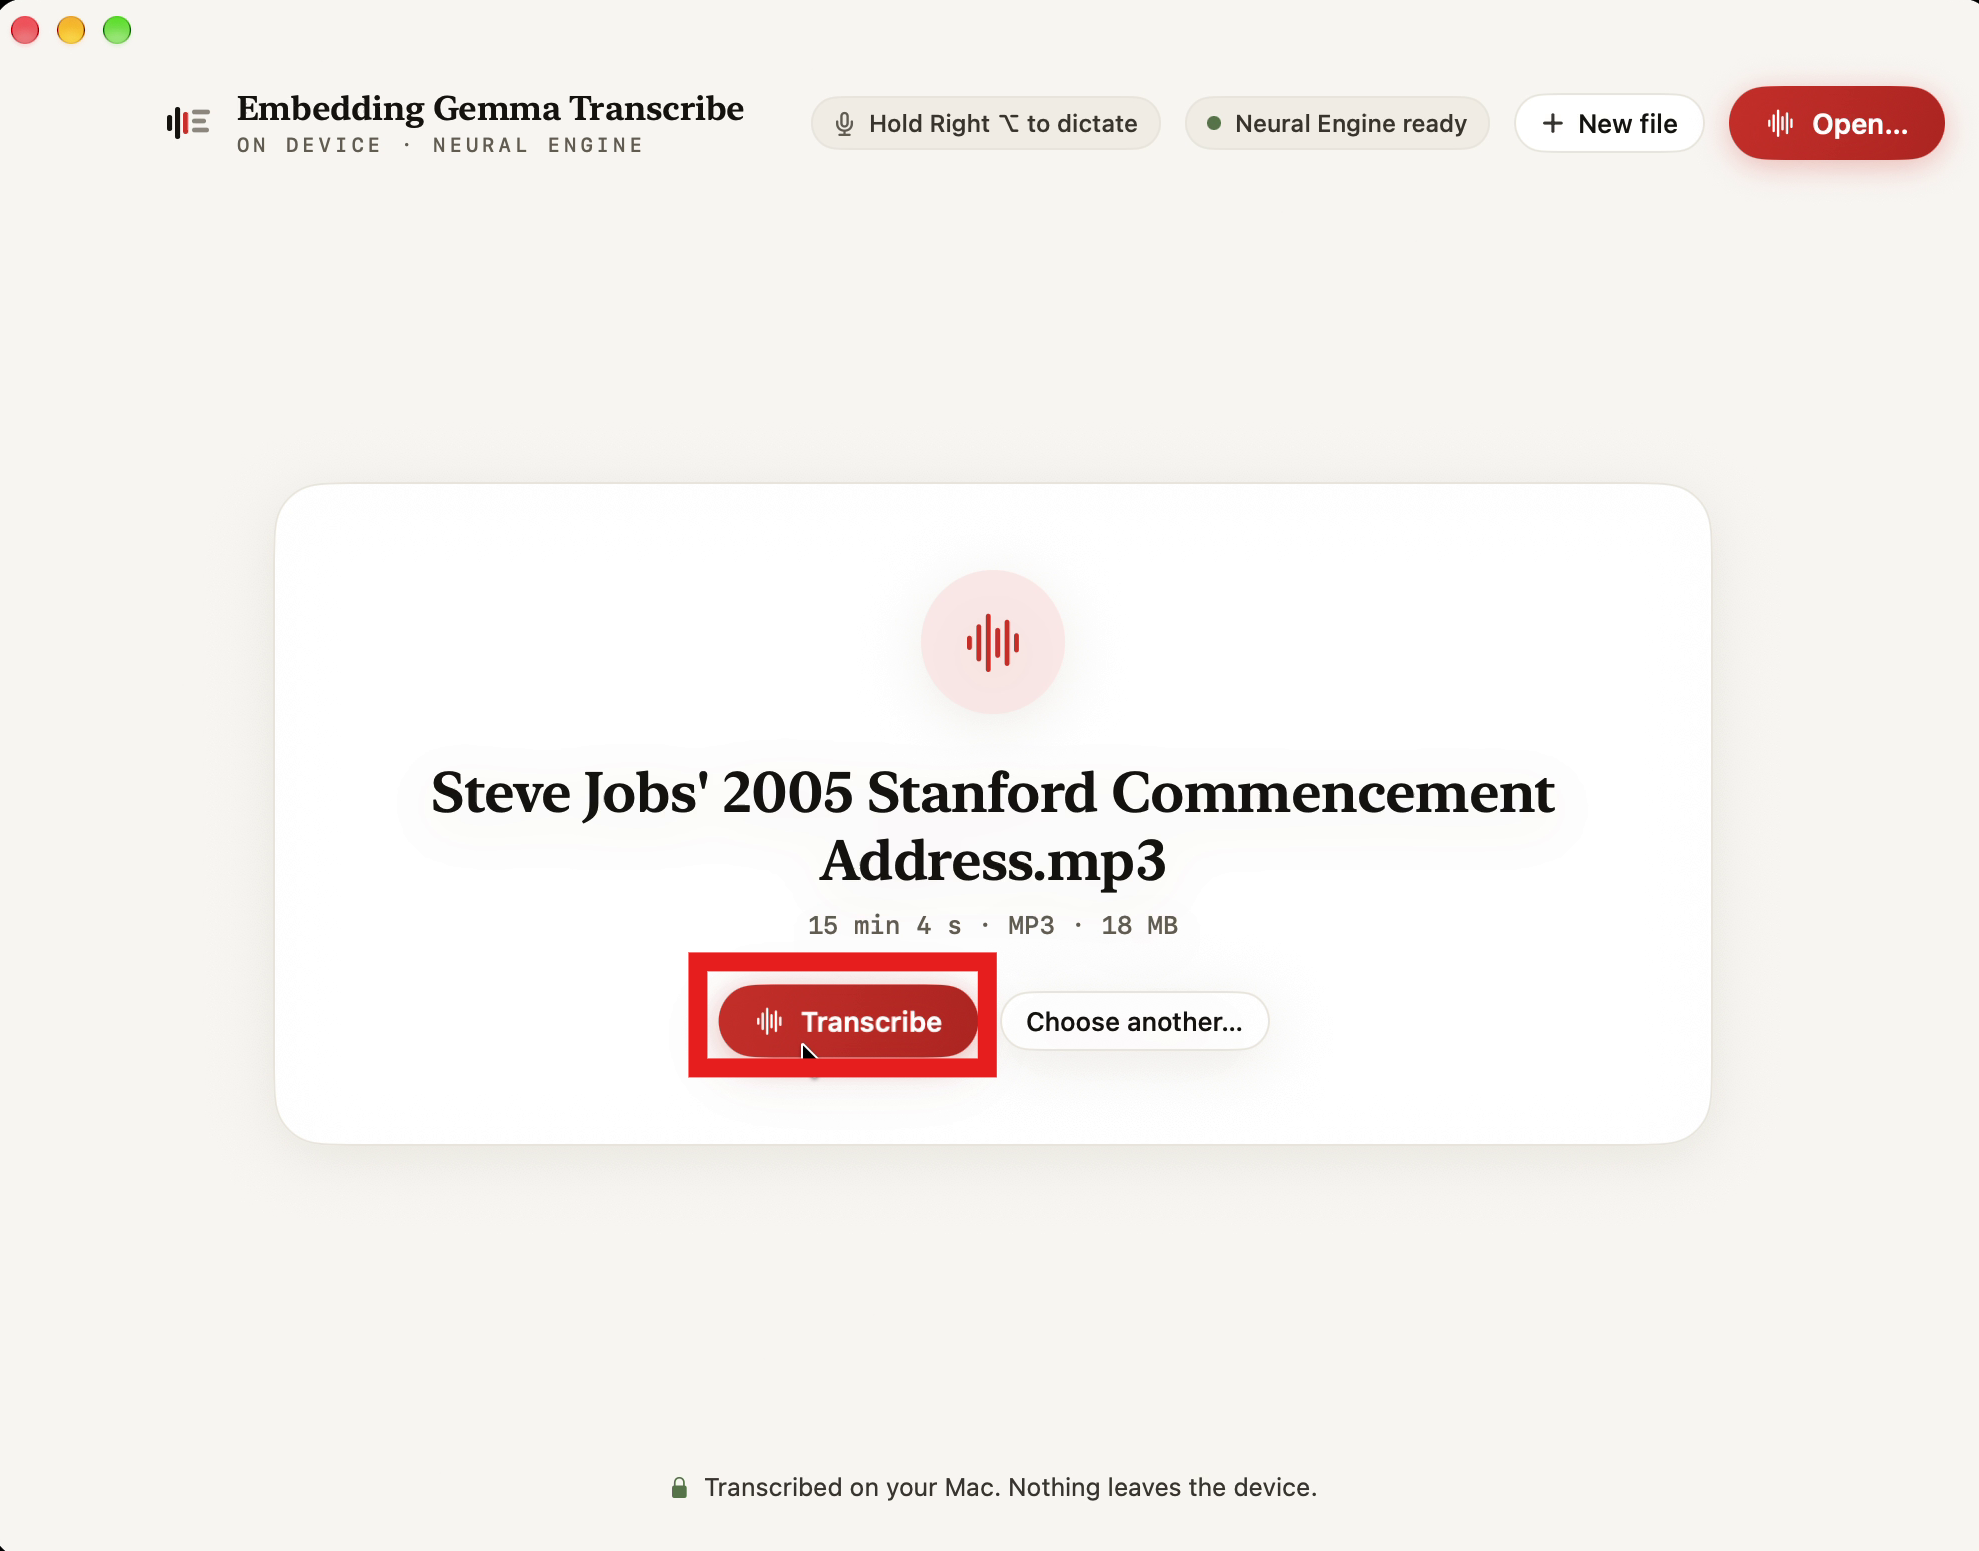
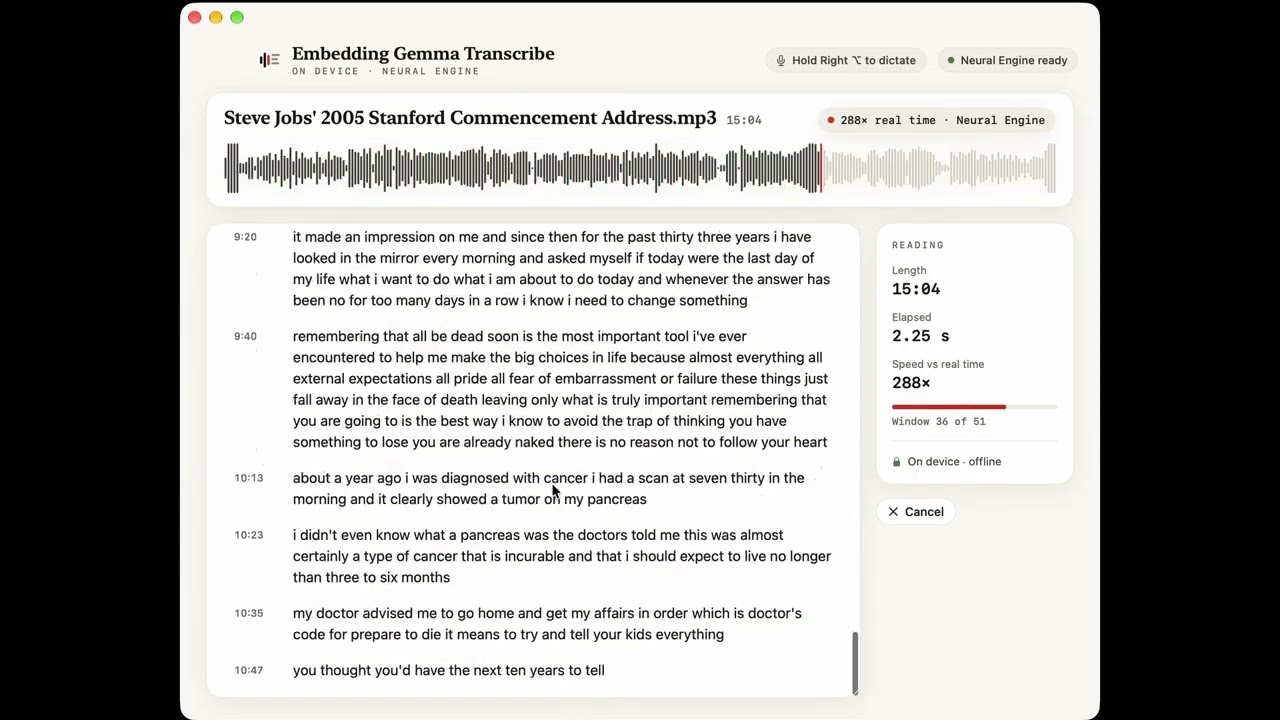
15分4秒の演説音声を文字起こしするのにかかった時間はわずか3秒。起こされた文章は左側に表示されています。
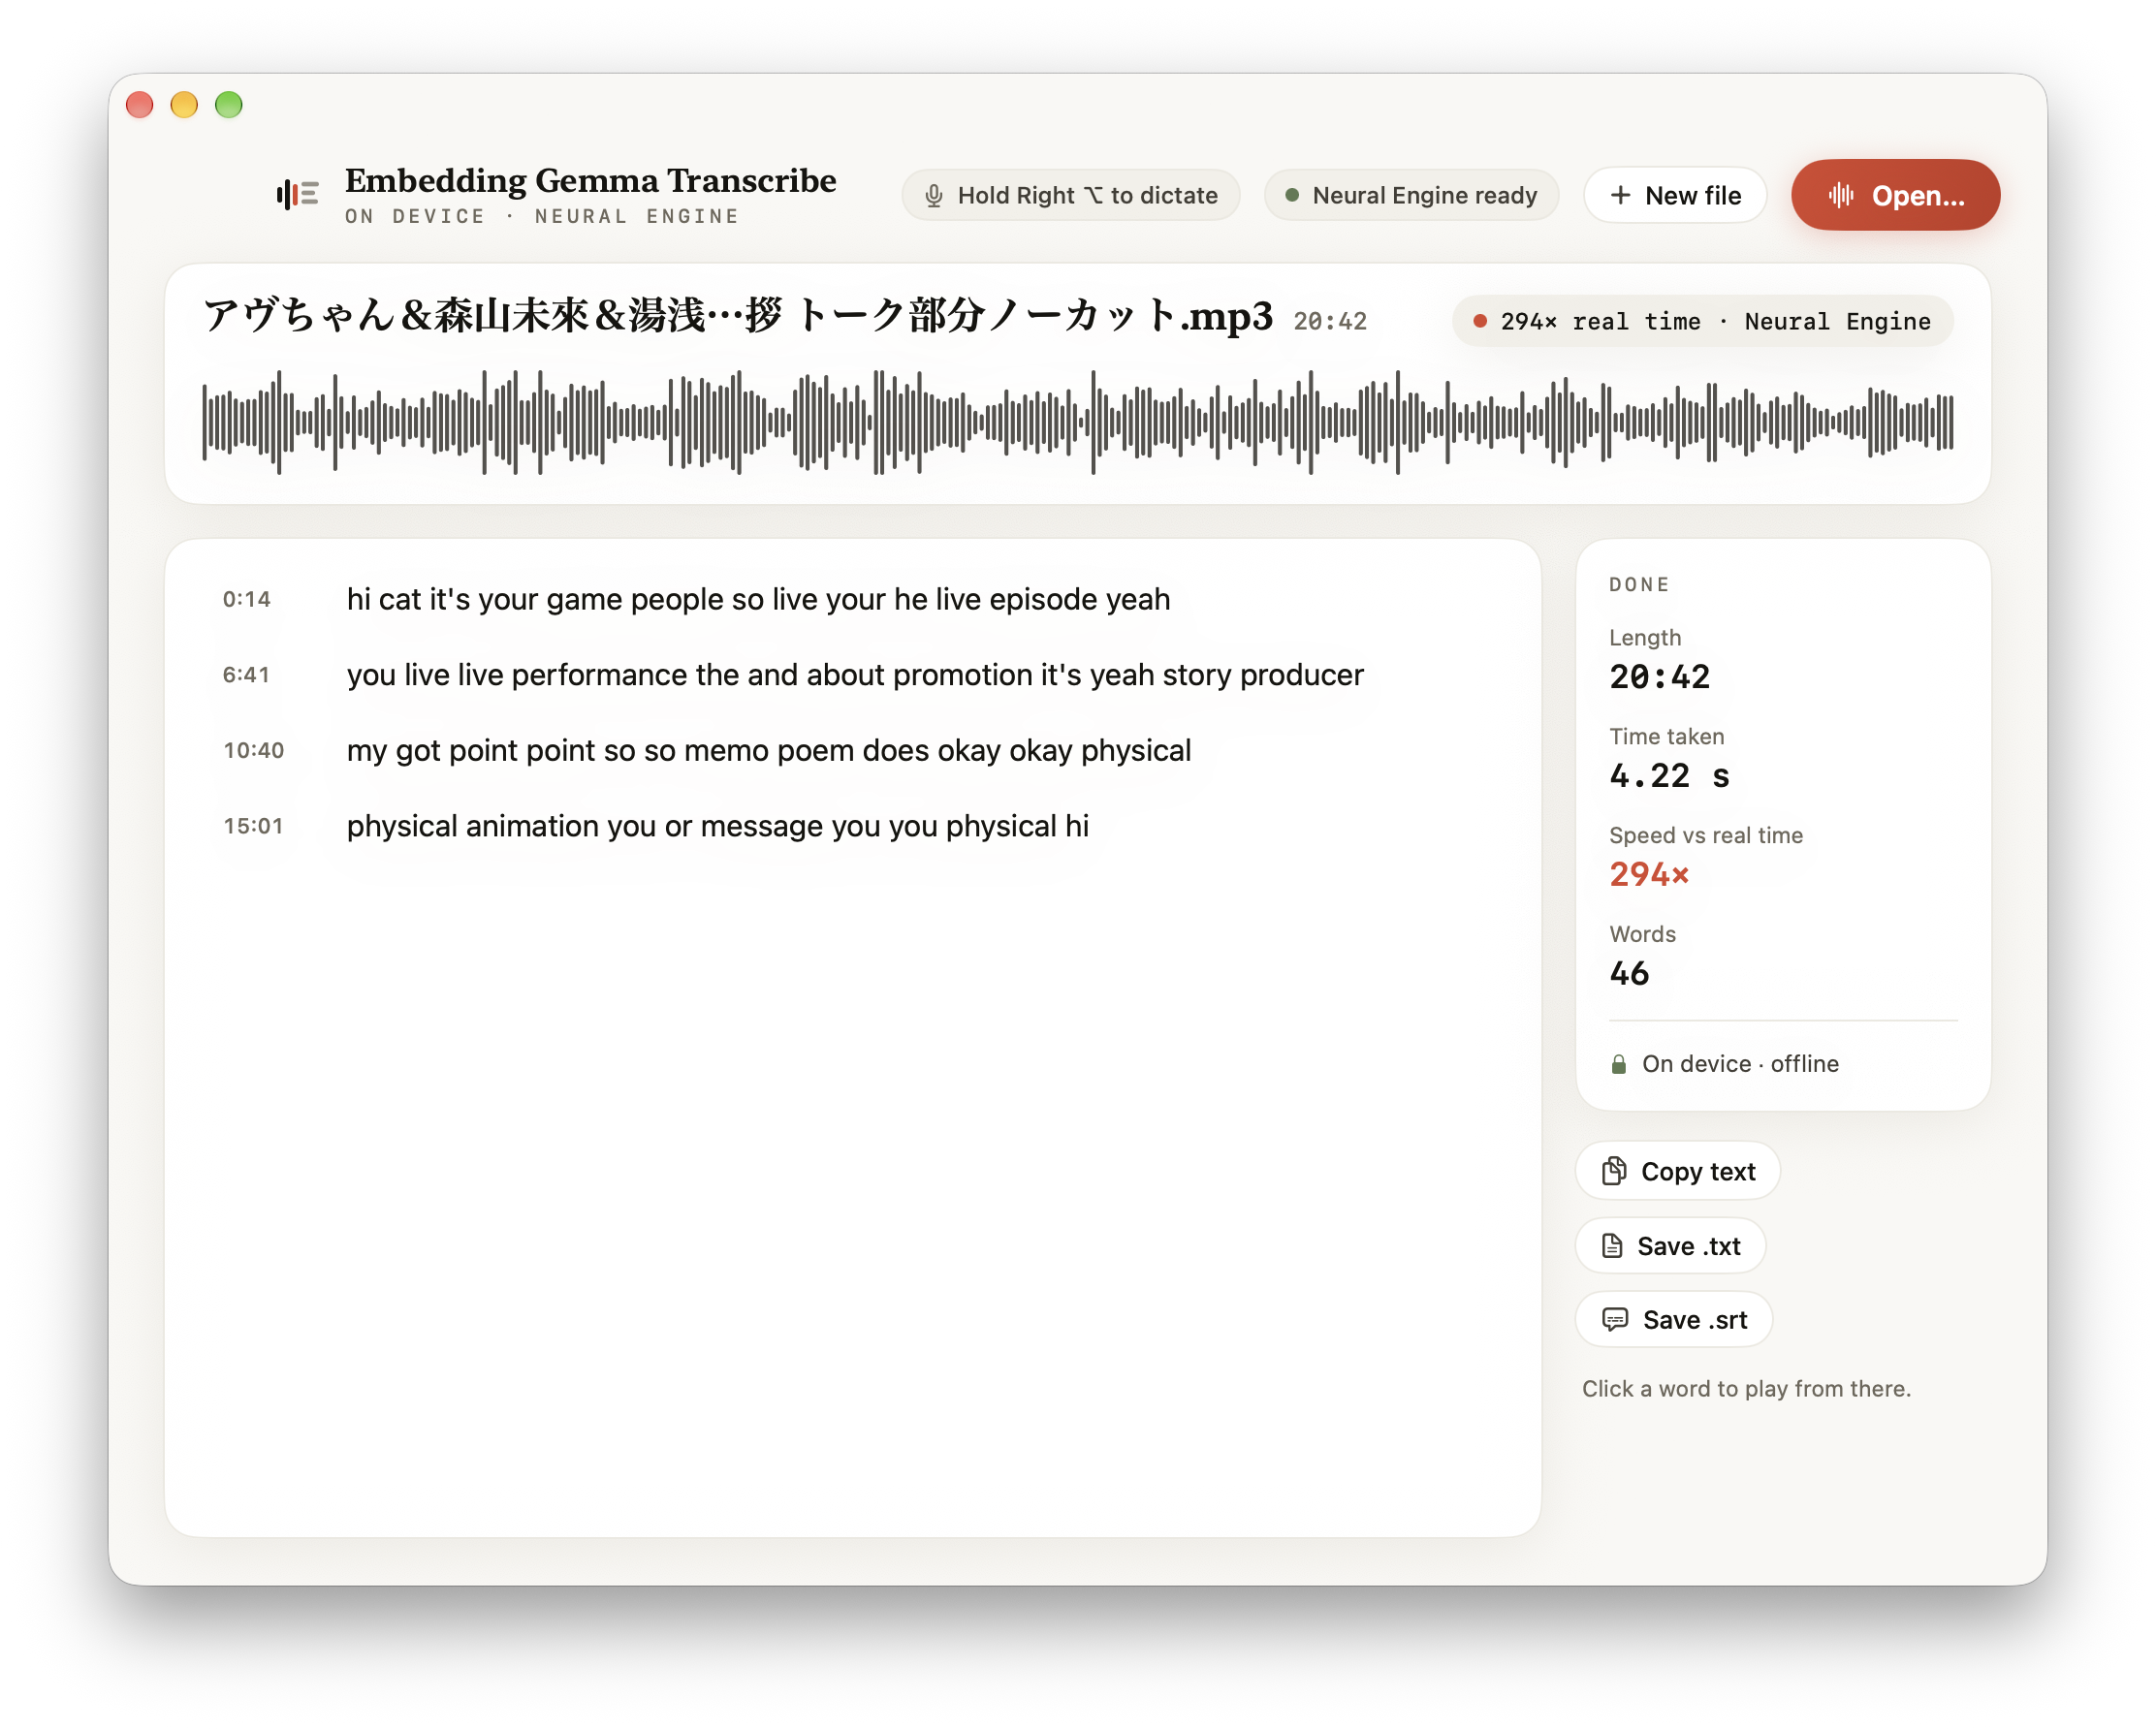
Embedding Gemma Transcribeは英単語の辞書を使って音声を文字に変換しているというシステムなので、日本語音声の文字起こしには対応していません。試しにアヴちゃん&森山未來&湯浅政明監督による映画「犬王」舞台挨拶の音声を文字起こししてみたところ、以下のような内容になりました。全体的に「空耳」な感じで、まったく文字起こしにはなっていませんが、3行目の「メモ」「ポエム」のようにアヴちゃんの話に出てきた英単語が拾われている部分もあります。
なお、開発者によればEmbedding Gemma Transcribeの認識精度は最高水準のモデルに及ばず、単語誤り率は約5%と、主要な高性能音声認識モデルの2~3%より高いものの、さらなるトレーニングにより改善が見込まれるとのことです。
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.