Нейрослоп не пройдёт: отбор в первую Школу аналитиков hh
Мы получили больше 250 тестовых на 25 мест в первую Школу аналитиков hh. Многие решения были сделаны с нейросетью, и это нормально — аналитики в работе тоже пользуются LLM-инструментами. Вопрос был в другом: как за аккуратным текстом от LLM разглядеть кандидата с пониманием того, что он делает.
Я — Валя Борисов, тимлид команды аналитики Trust&Safety в hh.ru, и параллельно организатор процесса отбора в Школу аналитиков. По долгу основной работы стараюсь сделать так, чтобы все стороны найма обладали достоверной информацией друг о друге. Тестовое в эру нейрослопа ставит ту же задачу: понять, стоит ли за красивым результатом сам человек.
Для начала немного контекста. В сентябре 2026 года hh запустил первую Школу аналитиков. Основная цель — обучить ребят-студентов, которые заряжены получить практический опыт в аналитике, а потом взять их на стажировки в команды. Концепция школ для нас не новая: на данный момент прошло 3 Школы продактов и 16(!!!) Школ программистов. Школу программистов прошло более 375 человек, из которых 110+ попали в технический департамент hh.
Общая рамка отбора
Перед любым отбором возникает вопрос, а кого мы вообще хотим видеть как целевого студента школы? В Школе аналитиков мы делаем акцент на практических навыках. Поэтому фокус хотелось сделать на ребятах, кто умеет интерпретировать данные и давать применимые к жизни рекомендации. Это приводит к первой проблеме — уход от рамки академических задач усложняет проверку и повышает уязвимость к нейрослопу.
Рядом есть вторая проблема — «аналитика данных» ещё не прижилась как полноценная дисциплина в большинстве университетских программ. Python, SQL, Matlab, R, Excel - все владеют разным инструментарием. Мы решили, что лучший вариант — не требовать знание конкретных языков, а дать выбрать самый удобный вариант. Спойлер: 85+% всё равно выбрали Python)
Практические проблемы
Окей, нам нужны практико-ориентированные задачи, которые не привязаны к конкретному ЯП и доступны студентам разных курсов. А как сделать задачи, которые позволят ранжировать кандидатов по уровню? В эпоху ИИ-агентов стопроцентный слоп в тестовом может выглядеть убедительнее реального решения. С другой стороны, использование современных инструментов позволяет быстрее и эффективнее делать работу, поэтому штрафовать за сам факт использования нецелесообразно. Хотелось придумать задачи, где максимальный балл получат работы, рождённые из кооперации с LLM-кой.
Слоп для нас — это когда кандидат берёт ответ модели как есть, не проверяя и не понимая, что там написано. Чтобы отделить разумное использование моделей от слопа, в задачи добавили несколько «ловушек», которые должны показать использование ИИ без достаточной валидации. Например, избыточно сложные вопросы или просьба написать комментарий. Причем ловушки были двух типов:
«Штрафные» стоили баллов — грязь в данных, рекомендация без учёта контекста задачи и т.п.
«Сигнальные» (те самые сложные вопросы и комментарий) на балл не влияли, а просто помогали отловить работы, которым надо уделить больше внимания на ручной проверке и интервью.
Ещё один челлендж — оптимизация ресурсов на отбор. Детальная ручная проверка самый точный вариант, но при потоке из 250+ сданных тестовых на это уйдёт 100+ человеко-часов сотрудников. К тому же нам не обязательно иметь точное ранжирование кандидатов, достаточно классифицировать на прошедших порог и нет. Для этой цели отлично подошли передовые ИИ-модели с автоматизированной проверкой по машинно-адаптированным маркингам и выборочным контролем со стороны проверяющего. Но об этом чуть позже)
В финальной итерации решили остановиться на двух задачах:
Анализ датасета
Теория вероятностей и статистика — критический разбор поста в соцсети
Каждая задача делилась на четыре смысловых блока:
Посчитать
Найти подвох в распределении или в логике
Интерпретировать
Дать рекомендацию
Давайте разберём подробнее задачи, подходы к решению и слоп-ловушки.
Задача 1. Анализ датасета с зарплатами
Условие задачи 1: анализ зарплат
Вася — студент последнего курса, уже имеет год опыта работы продуктовым аналитиком, но планирует менять место работы. Прежде чем рассылать резюме, он хочет разобраться в рынке: понять, как зарплаты зависят от опыта, насколько они предсказуемы и на что вообще ему рассчитывать.
Вася выгрузил с hh.ru 100000 вакансий аналитика данных и просит тебя помочь ему разобраться в этих данных.
Датасет: vacancies.csv, 100000 строк.
Колонка | Тип | Описание |
|---|---|---|
| int | Идентификатор вакансии |
| float | Нижняя граница зарплатной вилки, ₽ (может отсутствовать) |
| float | Верхняя граница зарплатной вилки, ₽ (может отсутствовать) |
| str | Требуемый опыт: Нет опыта / От 1 года до 3 лет / От 3 до 6 лет / Более 6 лет |
| str | Город вакансии |
| str | Тип занятости: Полная занятость / Частичная занятость / Стажировка / Удалённая работа |
Зарплата может быть указана как полной вилкой (salary_from и salary_to), так и одной границей, либо отсутствовать. Как корректно работать с этим — твоё методологическое решение, опиши его в ответе. Так как Вася выгружал всё самостоятельно, он не ручается, что нет ошибок парсинга.
Блок A. Технический
A1. Посчитай основные описательные статистики зарплат отдельно по каждому уровню опыта: среднее, медиану, стандартное отклонение, 25-й и 75-й перцентили. Представь результат в виде таблицы.
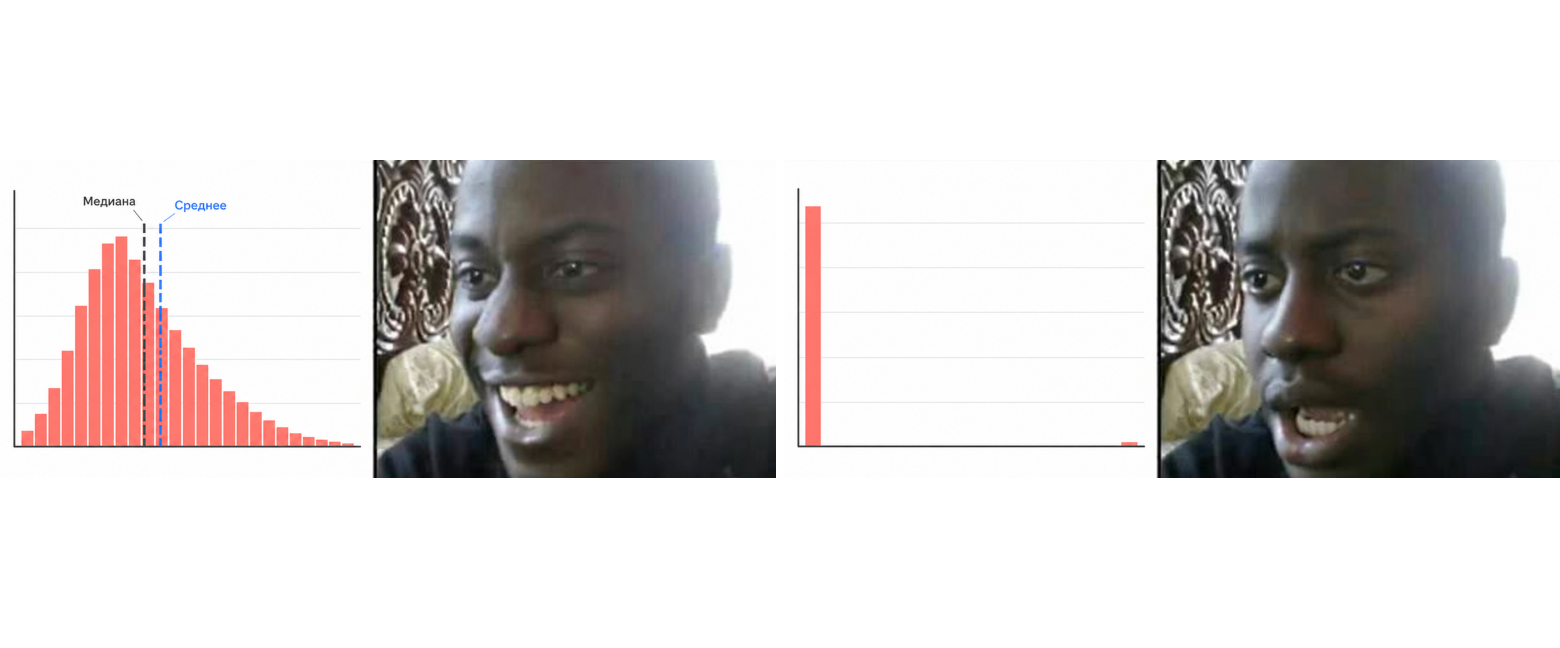
A2. Сравни значения среднего и медианы внутри каждой группы. Что ты замечаешь? Опиши наблюдение в одном-двух предложениях.
A3. Построй гистограммы распределения зарплат для каждого уровня опыта. Размести их так, чтобы группы можно было визуально сопоставить друг с другом.
Блок B. Аналитический
B1. Посчитай коэффициент асимметрии (skewness) для распределения зарплат в каждой группе опыта. В каких группах распределение скошено сильнее всего? В какую сторону? Чем это может объясняться?
B2. Объясни, почему в результатах из A2 среднее и медиана расходятся именно таким образом. Как это расхождение связано со скошенностью, которую ты посчитал в B1?
B3. В какой группе разброс зарплат наибольший? Посчитай его, используя нужные метрики. Что это означает для кандидата, который хочет предсказать свою будущую зарплату, ориентируясь на эти данные?
Блок C. Интерпретация
C1. Какую метрику (среднее, медиану или может что-то третье) правильнее использовать для описания «типичной» зарплаты в каждой группе? Обоснуй выбор, опираясь на форму распределения, которую ты обнаружил в блоках A и B.
C2. Вася нашёл в интернете статью, где написано: «средняя зарплата аналитика данных с опытом 1–3 года — N рублей». Должен ли он доверять этой цифре? Какие методологические оговорки стоит сделать?
C3. Можно ли по имеющимся данным утверждать, что зарплаты аналитиков с опытом «От 3 до 6 лет» значимо выше, чем у аналитиков с опытом «От 1 года до 3 лет»? Если да, то на каком основании. Если нет, то каких данных или инструментов не хватает, чтобы ответить на этот вопрос строго?
Блок D. Рекомендация
D1. Вася собирается на собеседование и хочет назвать «среднюю зарплату по рынку» при обсуждении оффера. Какую именно цифру ему использовать и как её корректно интерпретировать с учётом того, что ты узнал о форме распределения зарплат? Дай конкретную рекомендацию и обоснуй её.
D2. Глядя на разброс зарплат внутри грейдов: насколько предсказуема зарплата Васи, если он выйдет на рынок прямо сейчас? Где неопределённость выше, где ниже? Что это означает для его стратегии поиска работы?
D3. Сформулируй 2–3 конкретных вывода для Васи в виде коротких тезисов: что ему делать с этой аналитикой на практике.
Блок A
Датасет был синтетическим, и в него зашили некоторые аномалии:
перевёрнутые вилки
нереалистичные зарплаты
строки без зарплат
бимодальность в группах и тп
Полностью справились с очисткой и описанием методологии всего 13% кандидатов.
Кажется, что передовые нейросети должны хорошо справляться с этой задачей, но делают они это с характерными слоп-паттернами: нереалистичные зарплаты нормируют (делят на 100 или умножают на 100), перевернутые вилки переворачивают без дополнительных комментариев, методологически безупречно чистят выбросы без привязки к бизнес-смыслу.
Машинно-сделанные гистограммы зачастую имели нулевую интерпретируемость. При некорректно выбранном способе очистки столбики схлопывались или группа с выбросами перекрывала все остальные.
Блок B
Блок начинается с расчёта skewness. Как показала практика, большинство кандидатов не знали, что это, и ожидалось, что они (возможно, при помощи нейросетей) узнают, что это. На этапе проверки тестового это невозможно оценить, но на этапе интервью понимание скошенности было одним из основных детекторов слопа.
Сильные кандидаты рассуждали про то, что в ИТ группа 1-3 года самая нестабильная по зарплатам из-за так называемых «скрытых мидлов». Это люди с небольшим опытом, которые быстро прогрессируют и начинают быстро получать мидловскую зарплату. Но помимо этого есть и фактор географии: в крупных городах зарплаты могут быть выше, чем в регионах, что тоже влияет на скошенность и форму распределения в целом.
Блок C
В C1 большинство кандидатов корректно решили использовать медиану в качестве основной метрики для сравнения зарплат. Особо сильные работы рассуждали про то, что медиану надо считать в рамках своего города или учитывать свой потенциал. Если Вася чувствует, что обладает хардами и софтами выше среднего, можно целиться в более высокий перцентиль по уровню зарплаты.
C3 — основная слоп-ловушка секции. Для ИИ очевидно, что надо проводить статистический тест, и цепочка рассуждений у него типовая: основная метрика — медиана, значит нужна непараметрика, значит тест Манна-Уитни. Кстати, строго говоря, медианы этот тест не сравнивает, он проверяет сдвиг распределений, и это отличный вопрос на защиту. Чтобы студент самостоятельно пришёл к такой идее и осознанно провёл его, надо понимать большую пачку побочных теоретических вопросов: что такое p-value, чем параметрический тест отличается от непараметрического, предпосылки каждого теста, ЦПТ и т.д.
Повторюсь, что нет ничего плохого, если работа делается при помощи LLM — плохо, когда используются методы, про которые кандидат вообще ничего не понимает. Официальный маркинг вообще не обязывал проводить тест Манна-Уитни, равно как и любой другой статтест.
Блок D
Любые рекомендации — самая сложная часть для LLM-моделей. Они начинают фиксироваться на цифрах и не учитывают общий контекст задачи: что Вася студент, но с опытом работы (где?), его мотивацию, формат занятости, университет и программу и т.п.
Отдельным кандидатам без LLM это тоже свойственно, но там хотя бы удаётся избежать явно нереалистичных вариантов. Итог в цифрах: полный балл за рекомендацию получили всего 6% кандидатов — меньше, чем за любой другой пункт задачи.
Задача 2. Критический разбор поста в соцсети
Условие задачи 2: пост коуча в соцсети
Вова — студент последнего курса прикладной математики, готовится искать первую работу в ИТ и хочет подойти к этому осознанно. Перед тем как откликаться на hh.ru, он решил собрать информацию о рынке и наткнулся в соцсети на пост карьерного коуча с эффектными статистиками о поиске работы.
Вова собирается использовать этот пост как основу для своей стратегии откликов, но он умный парень и хочет сначала разобраться, насколько утверждениям из поста вообще можно доверять.
Твоя задача: помочь Вове критически разобрать пост и построить адекватную стратегию.
Пост в соцсети
📈 5 фактов о поиске работы в ИТ на hh.ru, которые тебе никто не расскажет
Привет, мои дорогие будущие обладатели зарплаты 300к+/наносек! 🚀 На связи Стас, топовый карьерный коуч с 26-летним опытом трудоустройства ИТ-специалистов.
За последние 3 года я выпустил более 500 учеников. Сегодня решил поделиться с вами фактами, которые перевернут ваше представление о поиске работы. Сохраняйте, пересылайте, отмечайте друзей! 🔥
Факт 1. Я опросил 200 моих учеников после курса: 78% из них нашли работу в первый месяц! Лучшее доказательство того, что моя методика работает. (Кстати, набор на новый поток уже открыт, ссылка в шапке профиля)
Факт 2. Знаете, что объединяет всех получивших оффер? 85% из них указали в резюме SQL и Python. Цифры не врут — хочешь оффер, учи SQL и Python. Точка.
Факт 3. Согласно нашему внутреннему исследованию, в среднем нужно 35 откликов, чтобы получить первый оффер. Если ты отправил 35 и оффера до сих пор нет — пиши мне в личку, разберём твоё резюме (не бесплатно, конечно 😉).
Факт 4. Простая математика, друзья! Если твоя конверсия отклика в оффер хотя бы 10%, то после 20 откликов ты гарантированно получишь оффер. Так что хватит ныть, просто отправляй больше откликов на hh!
Факт 5. Получил 10 отказов подряд? Не расстраивайся, следующий точно даст оффер, потому что отказы не могут идти бесконечно. Теория вероятностей на твоей стороне! 💪
Подписывайтесь, ставьте 🔥, делитесь с теми, кто ищет работу! Увидимся в ленте!
#зп300к #войтивайти #оффер
Блок A. Работа с числами в посте
A1. Автор пишет, что 78% из 200 его учеников нашли работу в первый месяц. Запиши это утверждение в виде вероятности: чему равно P(нашёл работу в первый месяц | ученик автора) и что это значит словами? Чему равна противоположная вероятность? Сколько учеников она описывает в абсолютных числах?
A2. Автор пишет: «85% получивших оффер указали в резюме SQL и Python». Запиши эту цифру в виде условной вероятности. Обозначь, что является событием A, что событием B и какая именно вероятность здесь известна.
A3. Предположим, у Вовы конверсия отклика в оффер составляет 10% (как в Факте 4) и каждый отклик независим от остальных. Посчитай (с короткими расчётами):
вероятность, что один отклик сразу станет оффером;
вероятность, что два отклика подряд оба не станут офферами;
вероятность, что все пять откликов подряд будут отказами.
Блок B. Условная вероятность и логика выводов
B1. Автор делает вывод: «85% получивших оффер указывают в резюме SQL и Python → хочешь оффер, учи SQL и Python». Какая именно вероятность известна автору, и какая вероятность нужна, чтобы сделать вывод, который он делает? Это одно и то же или разные вероятности? Нужны ли ещё какие-то данные, чтобы корректно ответить на вопрос «стоит ли учить SQL и Python ради оффера»?
B2. Автор опросил 200 своих учеников и получил долю 78%. Какие проблемы есть с такой выборкой? Объясни, может ли эта цифра быть систематически завышенной или заниженной, в какую сторону и почему. Как бы ты организовал сбор данных, чтобы получить более надёжную оценку реальной эффективности курса?
B3. Автор пишет: «Получил 10 отказов подряд? Следующий точно даст оффер, потому что отказы не могут идти бесконечно». Верно ли это утверждение с точки зрения теории вероятностей? Какое предположение об откликах здесь делается явно или неявно? Насколько это предположение реалистично в контексте реального поиска работы и что меняется в выводе, если оно не выполняется?
Блок C. Распределения
C1. Автор пишет: «Если твоя конверсия 10%, то после 20 откликов ты гарантированно получишь оффер (100%)». Верно ли это утверждение? Покажи правильный расчёт вероятности получить хотя бы один оффер на 20 откликах при конверсии 10%. К какому распределению относится эта задача? Если 20 откликов недостаточно для «гарантированного» оффера, сколько нужно отправить, чтобы вероятность хотя бы одного оффера была хотя бы 95%?
C2. В Факте 3 утверждается, что среднее число откликов до оффера равно 35. Опиши, как, по-твоему, выглядит распределение числа откликов до первого оффера среди реальных кандидатов. Симметрично оно или скошено? Где относительно среднего находится медиана? Что это означает для вопроса «если у меня отправлено 35 откликов и оффера нет, у меня что-то не так?». Можно ли вообще по одному числу (среднему значению) сделать вывод о норме?
Блок D. Интерпретация и стратегия
D1. Подведи итог критического разбора поста. По каждому из 5 фактов кратко сформулируй: какая в нём ошибка (или нет ошибки) и какой вывод следует делать из этого факта корректно. Представь это в виде списка или таблицы.
Дополнительно: напиши короткий (3–5 предложений) комментарий к посту от лица Вовы, который бы предупредил других читателей о ключевых проблемах с утверждениями автора. Комментарий должен быть конструктивным, а не язвительным.
D2. На основе всего, что ты разобрал, дай Вове конкретную стратегию откликов. Стратегия должна включать следующую информацию:
сколько откликов отправлять в неделю и почему именно столько;
как долго продолжать в одном режиме, прежде чем что-то менять;
на какие сигналы реагировать и как именно корректировать стратегию.
Обоснуй каждый пункт. Решения должны быть подкреплены логикой и цифрами из предыдущих блоков.
D3. Какие у твоей рекомендации остаются риски и оговорки?
какие предположения ты делаешь и что произойдёт, если они окажутся неверными?
в каких ситуациях твоя стратегия НЕ сработает?
какую дополнительную информацию ты хотел бы получить, прежде чем уверенно рекомендовать эту стратегию Вове?
Блок A
Блок, по сути, разминочный — с ним справились 95% студентов с нейросетью или без.
Блок B
Блок на анализ утверждений автора. Каждое из утверждений содержит различные ошибки и неточности: самоотбор, ошибка выжившего, ошибка игрока, нет контрольной группы. Основной способ детектировать слабых кандидатов и потенциальный слоп — названия как из учебника у всех парадоксов, при этом игнорирование базовых предпосылок задач. Например, что отклики одного человека связаны общим фактором: резюме и выбор вакансий одни и те же. Тогда серия отказов не приближает оффер, а скорее даёт повод проверить резюме, и учебная «ошибка игрока» объясняет только половину картины.
Блок C
Если отклики действительно независимы и вероятность оффера у каждого одинакова, то распределение откликов до первого оффера — геометрическое распределение. Сигнал из той же серии, что Манн-Уитни тест: в C1 мы сами спрашивали, к какому распределению относится задача, а в C2 название никто не просил, и большинство кандидатов про геометрическое распределение не знают. При этом LLM-ный ответ в C2 его упоминает и выводит характеристики распределения на основе знания названия и его свойств. Хороший вопрос на защиту тестового на секции интервью.
Блок D
Комментарий Вовы — большой сигнал слопа. Обычно самостоятельно пишут короткие понятные фразы, иногда с юмором или в стилистике поста. Нейрослоп присылает простыню с эмодзи, «важно отметить» и прочими распространёнными паттернами AI-текста. Задача ничего сама по себе не решает и просто призвана отловить потенциальные слоп-работы, которым надо уделить больше внимания на этапе проверки или интервью.
Прочие паттерны в рекомендациях соотносятся с первой задачей.
В целом, кандидаты справились со второй задачей ощутимо лучше, чем с первой. Средний балл составил 86% от максимума против 68% у первой задачи. Хоть вторая задача и не была гейм-чейнджером при ранжировании кандидатов, она давала неплохое представление о степени самостоятельности выполнения.
Как проверяли
Выше я уже заспойлерил, что проверку решили частично автоматизировать. Тут целая россыпь сложностей, которую предстояло решить:
Машинный маркинг отличается от человеческого. Как убрать субъективность в субъективном задании?
Стоимость vs качество: frontier-модели подходят лучше, но стоимость по API получается большая
Сравнимость результатов: разные итерации могут давать разные баллы за одно и то же решение. Точно ли можно сравнивать разные работы между собой?
Маскирование персональных данных
Двигались итерационно.
Сначала сделали машинный маркинг. Он концептуально отличается от экспертного тем, что под каждый вариант проставления баллов прописан список условий, который должен быть выполнен. От ИИ-проверяющего свой выбор требуется обосновывать конкретными цитатами из работы. Схема такая:«за задачу стоит 0 баллов, пока ты не нашёл доказательств, подкреплённых цитатами, почему балл должен отличаться». Ещё одно отличие — можно прописать гораздо больше условий для повышения/снижения баллов, если он вписывается в контекст модели. Требования к выводу тоже строже: нужен детерминированный вывод, который легко будет распарсить…
Минус один — нужна модель, которая сможет это переварить. Кандидаты сдавали работы в разных форматах: pdf, html, doc; код: py, ipynb, sql, xlsx, r. Пробовали использовать gpt-6-luna, claude-5-sonnet, grok-4.6, но на внутренних тестах все модели сыпались на сложных случаях. В какой-то момент пришло понимание, что если хочется сделать процесс, которому можно доверять, то надо придумывать более сложные вещи на топовых моделях.
Бюджет нашёлся, и ниже я расскажу, как выглядела итоговая схема.
Сначала работы проходили через локально развёрнутую open-source модель для маскирования персональных данных в работах.
На пачку из 30 работ выделяются три независимых агента на базе gpt-6-astra. Каждый проверяет свою пачку из 10 работ, оформляет комментарии, выводы и спорные моменты. Затем те же агенты меняются работами и независимо проверяют работы друг друга (не видя прошлые результаты!). Если итоги первой и второй итерации расходятся, работа вместе с результатами обеих проверок отдаётся четвёртому агенту-судье (также на базе gpt-6-astra), который принимает финальное решение.
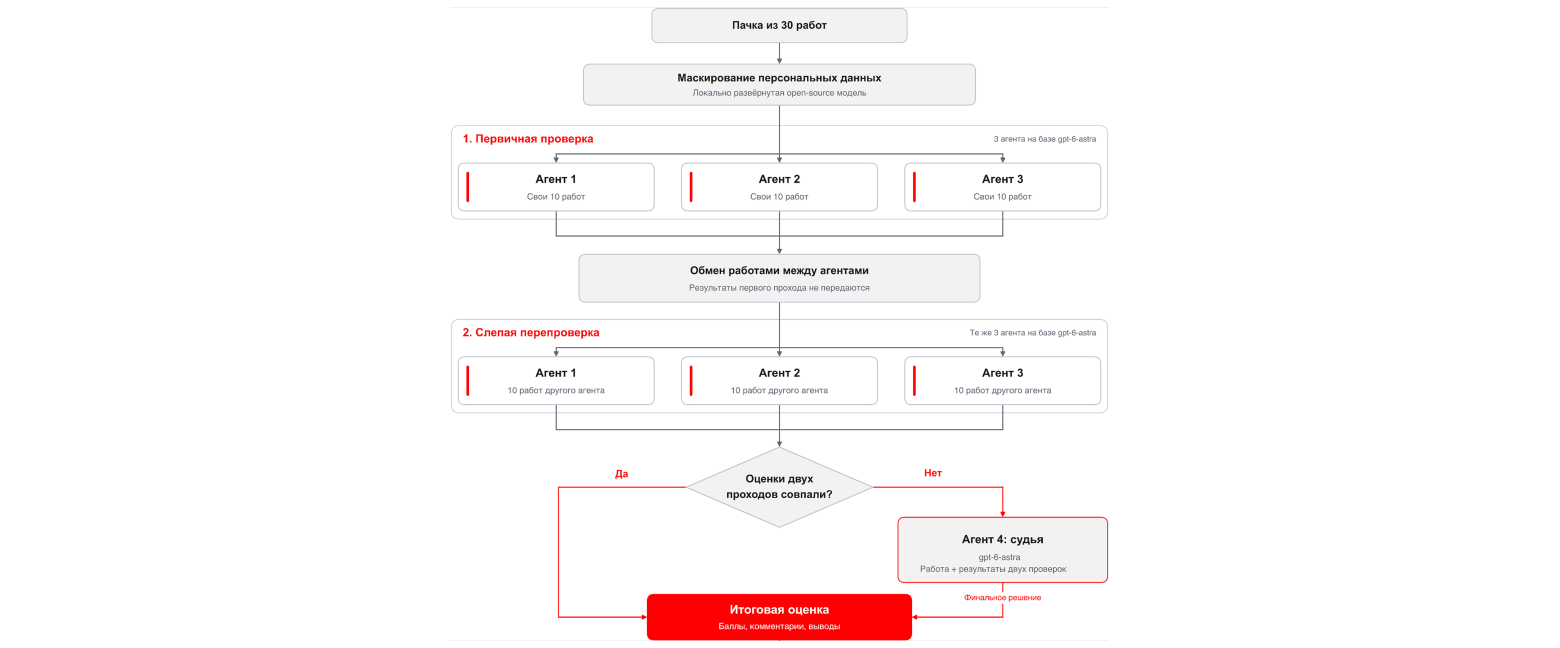
Проверка 250+ работ заняла около пяти часов параллельной работы агентов.
На тестовых прогонах устойчивость результатов была очень высокой. 10 независимых итераций давали примерно одинаковый балл (± 2/100), который совпадал с оценкой человека.
Поскольку, строго говоря, стояла задача recall-максимизации (всё-таки за каждым решением стоит потенциально замотивированный студент, на дальнейшую карьеру которого мы можем повлиять), то спорные работы отправлялись на ручную допроверку. Тут важно: подозрение на ИИ само по себе баллы не снижало. Слоп наказывался по-другому: штрафные ловушки встроены прямо в маркинг, и непроверенный ответ терял баллы за ошибки, а не за стиль. Сигнальные на балл не влияли вообще. Детекторы ИИ-текста ошибаются, ловушки неидеальны, поэтому решения об отсеве за слоп принимались только человеком. Подозрение от агента работало как флажок: такие работы я досматривал сам, а на интервью по ним задавал прицельные вопросы.
Живое интервью
Неоднократно уже упоминал интервью как следующий этап отбора. Оно служит финальным барьером между хорошо оформленным слопом и оффером в Школу аналитиков. На интервью позвали около 100 человек, собеседовали их 12 сотрудников. Каждое интервью шло 30 минут и делилось на три секции — мотивация, защита тестового и статистика с теорвером, за каждую от нуля до трёх баллов. Так что треть оценки за интервью складывалась из обсуждения тестового задания. Вопросы были разнообразные, но в основном связанные с ИИ-ловушками в работе — например, что на самом деле проверяет тест Манна-Уитни, что такое скошенность и почему из-за неё среднее больше медианы, откуда во второй задаче вообще взялось геометрическое распределение.
Смотрели и на косвенные признаки. Идеальная работа от студента, который не понимает концепцию математического ожидания — тоже большой сигнал слопа. Обсуждали и в целом подход к решению и использованию ИИ. Как показала практика, интервьюеры часто повышали оценку за грамотный и обоснованный подход к работе с LLM.
Итоги
Так как всё-таки разглядеть за аккуратным текстом от LLM кандидата, который понимает, что делает? Если коротко — ни один этап сам по себе ничего не решает, работает только связка. Задачи строили так, чтобы без своей головы было не вытянуть интерпретацию и рекомендации, в них встроили ловушки, а финальным барьером было живое интервью — там быстро видно, может ли человек объяснить своё же решение. Агенты сильно разгрузили проверку, но последнее слово по слопу всегда было за человеком.
При принятии решений мы руководствовались важным правилом — осмысленное использование ИИ-инструментов не является слопом. Самые сильные кандидаты комбинировали собственную экспертизу с проверяемой помощью LLM.
В цифрах: больше 250 тестовых, около 100 приглашений на интервью и 25 мест в первом потоке. К следующему набору ловушки и подход, вероятно, придётся обновить: эту статью прочитают и студенты, и модели)
Если сами нанимаете и уже придумали, как проверять тестовые в эпоху LLM — расскажите в комментах, интересно сравнить подходы. А если хотите в следующую Школу аналитиков — следите за набором.
Если вас заинтересовала аналитика в hh, приглашаю послушать наш новый «Статзначимый подкаст» — в нём мои коллеги обсуждают актуальные вопросы из продуктовой аналитики, делятся своим опытом, прогнозами и переживаниями. Подключайтесь, будет интересно!
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.