Мы храним записи сессий: почему heatmap тяжелее, чем stack trace, и как из этого выросла политика retention
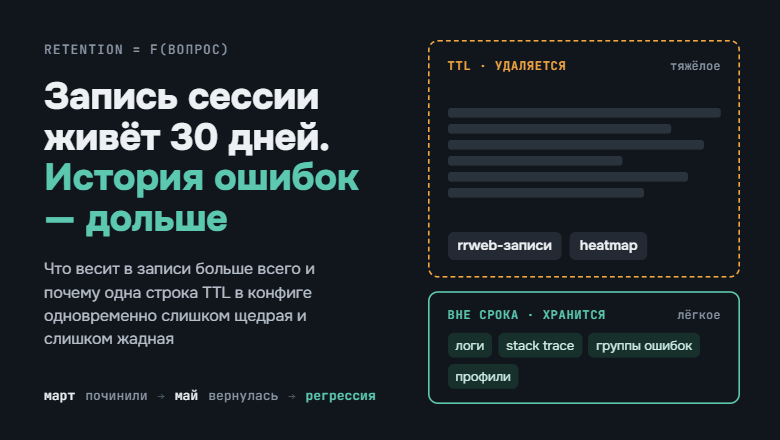
Из чего на самом деле состоит запись сессии, что в ней весит больше всего и почему историю ошибок нельзя удалять вместе с записями.
Привет! Я Паша, работаю над российским сервисом записи сессий пользователей Broux. Всё ниже основано на нашем опыте, со всеми его ограничениями.
Когда мы начинали, вопрос «сколько хранить» решался одной строкой в конфиге: всё живёт N дней, потом удаляется. Довольно быстро выяснилось, что эта строка одновременно слишком щедрая и слишком жадная.
Щедрая, потому что основное место занимали данные, которые через неделю почти никто не открывал. Жадная, потому что вместе с ними удалялось то, что как раз понадобилось бы через месяц. Расскажу, как мы это разделили и в каком месте до сих пор спорим.
Из чего состоит одна сессия
Если разложить запись сессии на части, получится три слоя. Разница в весе между ними не в разы, а на порядки.
Слой 1. Сама запись
Мы используем rrweb. Он делает полный снимок DOM при старте, а потом пишет поток изменений: мутации, движения мыши, скролл, ввод.
Главный сюрприз для тех, кто считает объёмы впервые: размер записи определяется не длиной сессии, а тем, насколько активно меняется интерфейс. SPA с виртуальным списком, который перерисовывает строки на каждом скролле, за минуту набирает больше, чем статичный лендинг за час.
Мы сознательно пишем подробно, потому что иначе плеер и карты кликов начинают врать:
стили встраиваем прямо в снимок, чтобы запись не развалилась, когда сайт обновит CSS;
пишем canvas и шрифты;
движение мыши снимаем раз в 50 мс;
ввод фиксируем посимвольно, уже замаскированным.
Всё это сжимается ещё в браузере и в базе тоже хранится в сжатом виде. И даже так получаются вот такие цифры:
Размер записи (в сжатом виде) | |
|---|---|
Медиана | ~220 КБ |
Каждая 10-я сессия | > 1 МБ |
Каждая 100-я сессия | > 3,5 МБ |
Рекорд за месяц | 24 МБ |
Ещё сильнее различаются проекты. У самого лёгкого проекта медианная запись весит 12 КБ, у самого тяжёлого 550 КБ, разница почти в 50 раз. Поэтому, когда нас спрашивают «а сколько места займёт мой сайт», мы честно отвечаем: зависит от сайта.
Слой 2. Технический
Логи консоли, сетевые запросы (URL, метод, статус, время ответа), stack trace исключений. Это текст, он отлично сжимается и весит больше чем на порядок меньше записей.
За три месяца на 100 000 сессий у нас набралось около 1,3 ГБ, примерно в 45 раз меньше, чем записи за тот же период. Интересно, как этот объём распределён: почти всё дают сетевые запросы, около 1,2 ГБ. Логи консоли, которые интуитивно кажутся главным «мусором», заняли всего 78 МБ.
Слой 3. Производные данные
Группы ошибок с трендом, UX-паттерны (rage click, dead click, брошенные формы), кастомные события, профиль пользователя. По сути это выжимка из первых двух слоёв.
Все ошибки и UX-паттерны у нас вместе занимают около 100 МБ, это в 500 с лишним раз меньше записей. При этом именно в этот слой заглядывают чаще всего, когда надо что-то решить.
Почему heatmap оказалась в тяжёлой корзине
Интуитивно карта кликов выглядит как набор координат, то есть почти ничего не весит. Отчасти так и есть: клики и скроллы всех сессий у нас вместе занимают меньше 0,5 ГБ.
Но карту нужно на чём-то показать, и для этого нужна сама страница.
Страница при этом не одна. Вышел релиз, запустили A/B-тест, пользователь открыл сайт с телефона: каждой версии нужен свой снимок, иначе клики лягут на кнопки, которых уже нет. Карта, где горячая точка висит над пустым местом, хуже, чем никакой карты.
У нас это устроено так:
Подложкой служит эталонный снимок страницы: полный слепок DOM со встроенными стилями.
Снимки разложены по трём классам устройств (мобильные, планшеты, десктопы), и на каждую пару «URL плюс устройство» мы держим пул из трёх лучших.
Трекер снимает их в разные моменты: сразу после загрузки, перед первым кликом и с задержкой, когда страница точно догрузилась.
Каждый снимок получает оценку. Если поверх страницы открыта модалка, крутится прелоадер или страница почти пустая, оценка снижается.
Снимок старше недели постепенно теряет в оценке. Поэтому после релиза старая подложка вытесняется новой сама, без ручной пересъёмки.
А теперь вес. Один эталон в среднем весит 60–330 КБ, а крупные доходят до мегабайта, то есть столько же, сколько типичная запись сессии. На большом проекте набирается 12 000 снимков на 5 000 адресов, это 2,5 ГБ. Всего снимки занимают около 4,3 ГБ, втрое больше всего технического слоя.
В итоге готовая карта по весу ближе к записи сессии, чем к логам. Поэтому и хранить её мы решили так же.
Что ломается, если удалять всё одним сроком
Самый показательный случай. Ошибку починили в марте, в мае она вернулась.
Если история удаляется через 30 дней, система увидит совершенно новую ошибку: без тренда, без списка тех, кого она задела в прошлый раз, и без понимания, что это регрессия. Разработчик начнёт расследование с нуля, хотя ответ уже был.
Мы хотели, чтобы вернувшаяся ошибка помечалась автоматически, а не обнаруживалась, когда о ней снова напишет клиент. Сейчас так и работает: если в «решённой» группе появляется новое вхождение, группа сразу становится активной. Но для этого история группы обязана жить дольше записей.
С профилем пользователя то же самое. Удалить его вместе с записью значит через месяц потерять ответ на вопрос «кто из клиентов уже сталкивался с этим раньше». А это первый вопрос, который задаёт поддержка.
Что получилось
Мы разделили данные на две корзины.
Под сроком хранения: записи сессий и готовые heatmap. Это 97% объёма. Они удаляются по истечении срока тарифа.
Вне срока: логи консоли, сетевые запросы, stack trace, группы ошибок с трендом, UX-паттерны, кастомные события и профили пользователей. Если хранить их дольше записей, объём вырастет всего на пару процентов. Это дёшево хранить и дорого терять.
Если сформулировать правило: срок хранения считается не от возраста данных, а от вопроса, на который они отвечают. Вопрос «что именно делал человек на экране» задают в первые дни после инцидента. Вопрос «было ли это раньше и у кого» нужен месяцами.
Где мы до сих пор спорим
Сетевые запросы. По смыслу это технический слой: лёгкий текст, который нужен для расследований. Но по весу это 90% технического слоя, и растут они быстрее всего. Один SPA-проект с активным API за день генерирует больше запросов, чем десяток лендингов за месяц.
Есть два лагеря. Первый: сеть — это контекст ошибки, и без неё stack trace через полгода теряет половину смысла. Второй: через полгода никому не нужен полный журнал запросов, достаточно тех, что окружали ошибку, а остальное можно удалять вместе с записью.
Пока мы склоняемся к компромиссу: долго хранить только те запросы, которые связаны с ошибками и UX-паттернами, а остальные удалять по сроку записи. Если вы решали эту задачу у себя, расскажите в комментариях, как. Нам правда интересно.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.