[ITmedia News] 立ち話が“宝の山”に 8人の声を聞き分けられたAI文字起こし「Klang」の実力
著者
 小寺信良
[ITmedia]
AIはプログラミングの世界で革命を起こしつつあるわけだが、ソフトウェア開発とは関係のない人たちに大きな恩恵を与えたのが、音声からの文字起こしではないだろうか。
以前は録音を聴きながら人間がタイピングして文字化するしかなかったわけだが、慣れた人でも1時間の書き起こしに数時間を要する。書き起こしのアウトソーシングを請け負う事業者もあり、それだけ需要も大きければ負担も大きい作業であった。
AIを使った文字起こしサービスは、開発中のβバージョンは無料で利用できたりしたものだが、現在はほとんどのサービスが開発を完了し、有料プランへと移行している。またボイスレコーダーとセットで文字起こしおよびサマリー化を自動化するサービスも人気があるところだ。筆者は今のところ「Plaud」を契約し、便利に使っているところである。
Plaudは、録音の音声データを元にサマリーを作るのは非常に得意である一方、単純な文字起こしの精度はそれほど良くないところが課題である。例えば話者が複数人いた場合の話者判別は、インタビュー記事や対談記事などを執筆する上で欠かせないところである。
インタビュー取材は、質問に対する回答という形で聞き手と話し手が分離されているが、立ち話のような雑談では誰かがその場を仕切るというわけでもなく、会話や相づちがかぶったり、明確なQAスタイルになっていない。こうした録音で話者を分離するのは、既存の日本語向け音声書き起こしサービスではかなり難しいようだ。
現在いろんなサービスを試してみているところだが、その中でも今後注目しておきたいのが、スウェーデンの「Klang」というサービスである。スウェーデン語モデル「Klang Pianissimo」の開発経験をベースに、日本語音声認識モデルの学習を近く開始する予定で、研究開発や海外展開のため新たに約2.4億円の資金調達を行った。日本はその重点市場の1つである。
これまで北欧を中心に事業を展開しており、DACH地域(ドイツ、オーストリア、スイス)とベネルクス地域(ベルギー、オランダ、ルクセンブルク)での展開も進めている。2026年8月には日本語版の提供を開始している。ただし現在のモデルはKlang Pianissimoではなく、別の日本語モデルだ。
実際の結果
先日、京橋で開催された「CREATORS EDGE 2026」というイベントを取材した。写真・映像クリエイターのセミナーと、機材展示が同時に見られるという展示会である。Plaudのレコーダーを回しっぱなしにして各ブースを取材し、途中知り合いのカメラマンたちに会ったので、そこで立ち話的に情報交換をした。
一般的に、テーマが異なる話が同じ録音ファイルに存在すると、AIによるサマリーは、統一されたテーマを探そうとするので、うまくいかないことが多い。加えて多数の話者が入れ替わり立ち替わり登場するため、ベタの書き起こしも話者の切り分けもあまりうまくいかない。
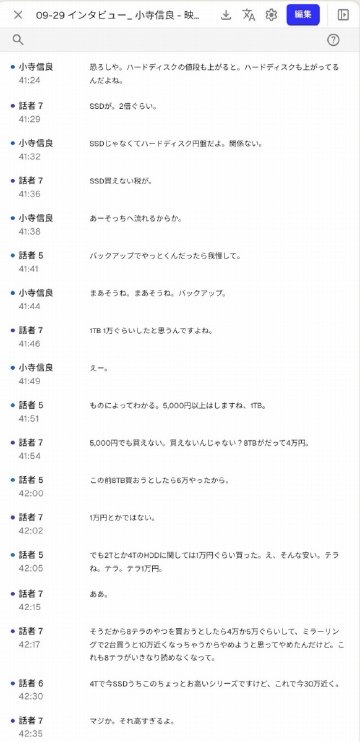
この録音ファイルをKlangにかけてみたところ、かなり良い結果が得られた。ベタの書き起こしでは、話者が8人に分けて認識されていた。実際この切り分けは正しい。同じ録音部分の書き起こしを比較すると、Plaudは話者の切り分けがうまくいかないために文字化できていない部分がある一方で、Klangでは話者分離が正確で、それぞれを細かく書き起こしていることが分かった。
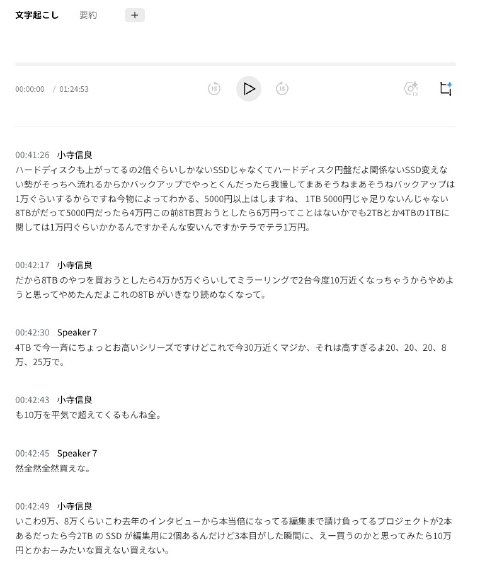
一方サマリーは、Plaudが得意とするところである。特に指示しなくても、複数のテーマに対するサマリーができていた。Plaudは言語認識に際して使用するAIモデルやテンプレートが選択できるので、割と期待通りの成果が得られる。
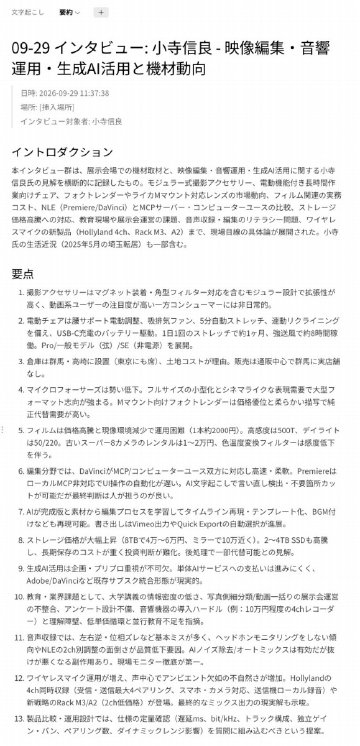
一方Klangのサマリーでは、一番長い雑談ブロックの部分だけが抽出されていた。そこで以下のような指示を出して再構築してもらった。
「この録音は、展示会での複数のブース取材を録音したものです。録音内容から各ブースの取材の切れ目を推測し、それぞれのブース取材に対するサマリーを制作してください。」
するとKlangは、各ブース取材と、ブース取材以外の雑談パートがあることを認識し、それぞれのサマリーを作るというアプローチを開始した。
「展示会取材の内容を確認いたしました。音声全体を分析した結果、明確な「ブース取材」と判断できる区間と、そうではない区間(小寺信良様ご本人への単独インタビュー・雑談パート)が混在していることが分かりました。それぞれを区別しつつ、ブース単位でサマリーをまとめた文書を作成します。」
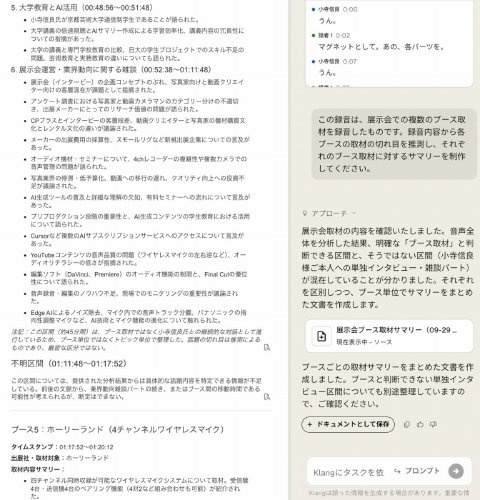
日本語モデルの学習と評価はまだこれからだというが、日本語の指示に正確に反応しており、現在のモデルでもかなり良い結果が得られている。
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.